Większość porad dotyczących architektura strony internetowej zaczyna się od liczby: utrzymuj każdą ważną stronę w odległości trzech kliknięć od strony głównej. Obserwowałem, jak ta zasada przynosiła odwrotne skutki od zamierzonych. Duże witryny spłaszczały swoją architekturę informacyjną w nakładające się centra, publikowały skrótowe podsumowania i utrudniały zrozumienie, która strona odpowiada jakiemu zamiarowi.
Silna architektura nie jest płaska dla samej siebie. Jest to system, który pomaga wyszukiwarkom odkrywać wartościowe adresy URL, pomaga użytkownikom zrozumieć, gdzie się znajdują, i zapewnia każdemu tematowi głębię wymaganą przez jego odbiorców. Właściwy model to zazwyczaj inteligentna hybrydowa głębia: płytki dostęp do stron o wysokiej wartości, głębsze ścieżki do archiwów i specjalistycznych zasobów oraz linki wewnętrzne, które uwidaczniają relacje między nimi.
Spis treści
- Dlaczego płaska architektura jest złym celem
- Zbuduj semantyczną strukturę nagłówków i obszarów.
- Projektowanie struktury adresów URL i silosów tematycznych
- Zastosuj regułę linkowania wewnętrznego, która działa
- Nie umieszczaj krytycznych treści w kolejce renderowania
- Audyt budżetu indeksowania i luki w bezpiecznym dostarczaniu
- Struktura dla przeglądów AI, nie tylko niebieskich linków
- Czego nauczyłem się, przebudowując stronę z 20 tysiącami stron
Dlaczego płaska architektura jest złym celem
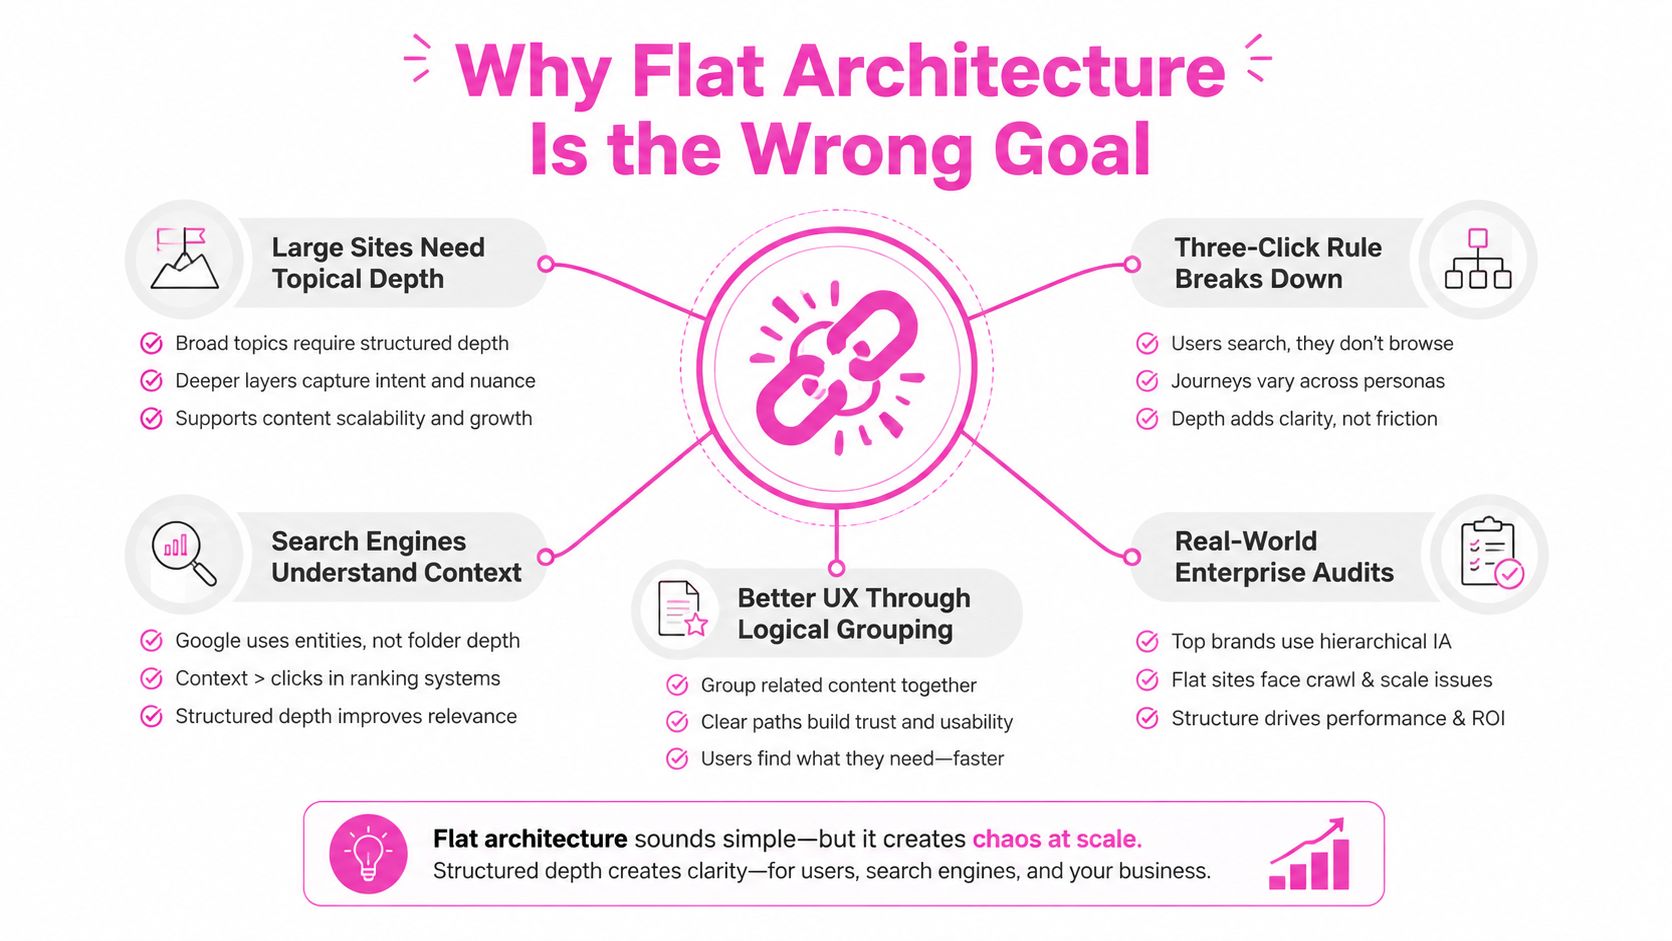
Zasada trzech kliknięć jest przydatna jako narzędzie diagnostyczne, ale jest słabym uniwersalnym prawem. Kiedy audytuję strony korporacyjne, nie pytam, czy każdy adres URL jest równie blisko strony głównej. Pytam, czy strony, które zasługują na popyt, linki, konwersje lub częste aktualizacje, są łatwo dostępne z odpowiednich hubów.
Wymuszanie, aby każda strona znajdowała się w płytkiej strukturze, często tworzy słabe strony kategorii. Kilka hubów kończy się na celowaniu w to samo szerokie wyrażenie, podczas gdy szczegółowe treści są pozbawione kontekstu, który czynił je użytecznymi. Rezultatem jest bardziej płaska strona, którą trudniej inteligentnie indeksować i trudniej użytkownikom się po niej poruszać.
Używaj głębokości zgodnie z wartością strony
Obecne wskazówki SEO coraz częściej faworyzują hybrydowy lub „inteligentnie płaski” model. Strony krytyczne dla przychodów pozostają w zasięgu trzech kliknięć, podczas gdy archiwa i specjalistyczne treści mogą znajdować się głębiej, gdy hierarchia nadaje tym stronom jasny kontekst tematyczny. Rozróżnienie to jest omawiane we wskazówkach SEO dotyczących inteligentnej płaskiej architektury, i pasuje do tego, jak priorytetyzuję rzeczywiste strony.
Zazwyczaj umieszczam te strony blisko głównych hubów:
- Komercyjne strony docelowe: Strony produktów, usług, kategorii i porównań bezpośrednio związane z intencją biznesową.
- Strategiczne huby redakcyjne: Strony, które konsolidują znaczący temat i linkują do jego najważniejszych podtematów.
- Świeże lub często aktualizowane zasoby: Treści, w których szybkość odkrycia wpływa na wartość biznesową.
- Docelowe strony o wysokim autorytecie: Adresy URL, które przyciągają zewnętrzne linki i powinny dystrybuować trafność w obrębie witryny.
Archiwa, zasoby historyczne, szczegółowa dokumentacja i strony niszowych bytów mogą znajdować się głębiej, jeśli mają opisowe okruszki nawigacyjne, silne linki nadrzędne i odpowiednie ścieżki powrotne do hubu. Głęboki adres URL nie jest automatycznie słaby. Niejasny adres URL jest.
Praktyczna zasada: Utrzymuj ważne strony na płytkim poziomie ze względu na wartość biznesową, a nie arbitralną odległość od strony głównej.
Model architektury opisany przez Kogifi w hierarchii witryny jest przydatne, gdy zespoły muszą zrównoważyć dostępność z sensownym grupowaniem. Sprawdzam również, czy strona zasługuje na swoje miejsce w centrum, analizując jej cel, unikalne informacje, linki wewnętrzne i rolę konwersji. Jeśli nie wnosi żadnej wyraźnej wartości, łączę ją. Jeśli odpowiada na specyficzne potrzeby, pozwalam jej zachować głębię i wzmocnić jej powiązania.
Zbuduj semantyczną strukturę nagłówków i obszarów.
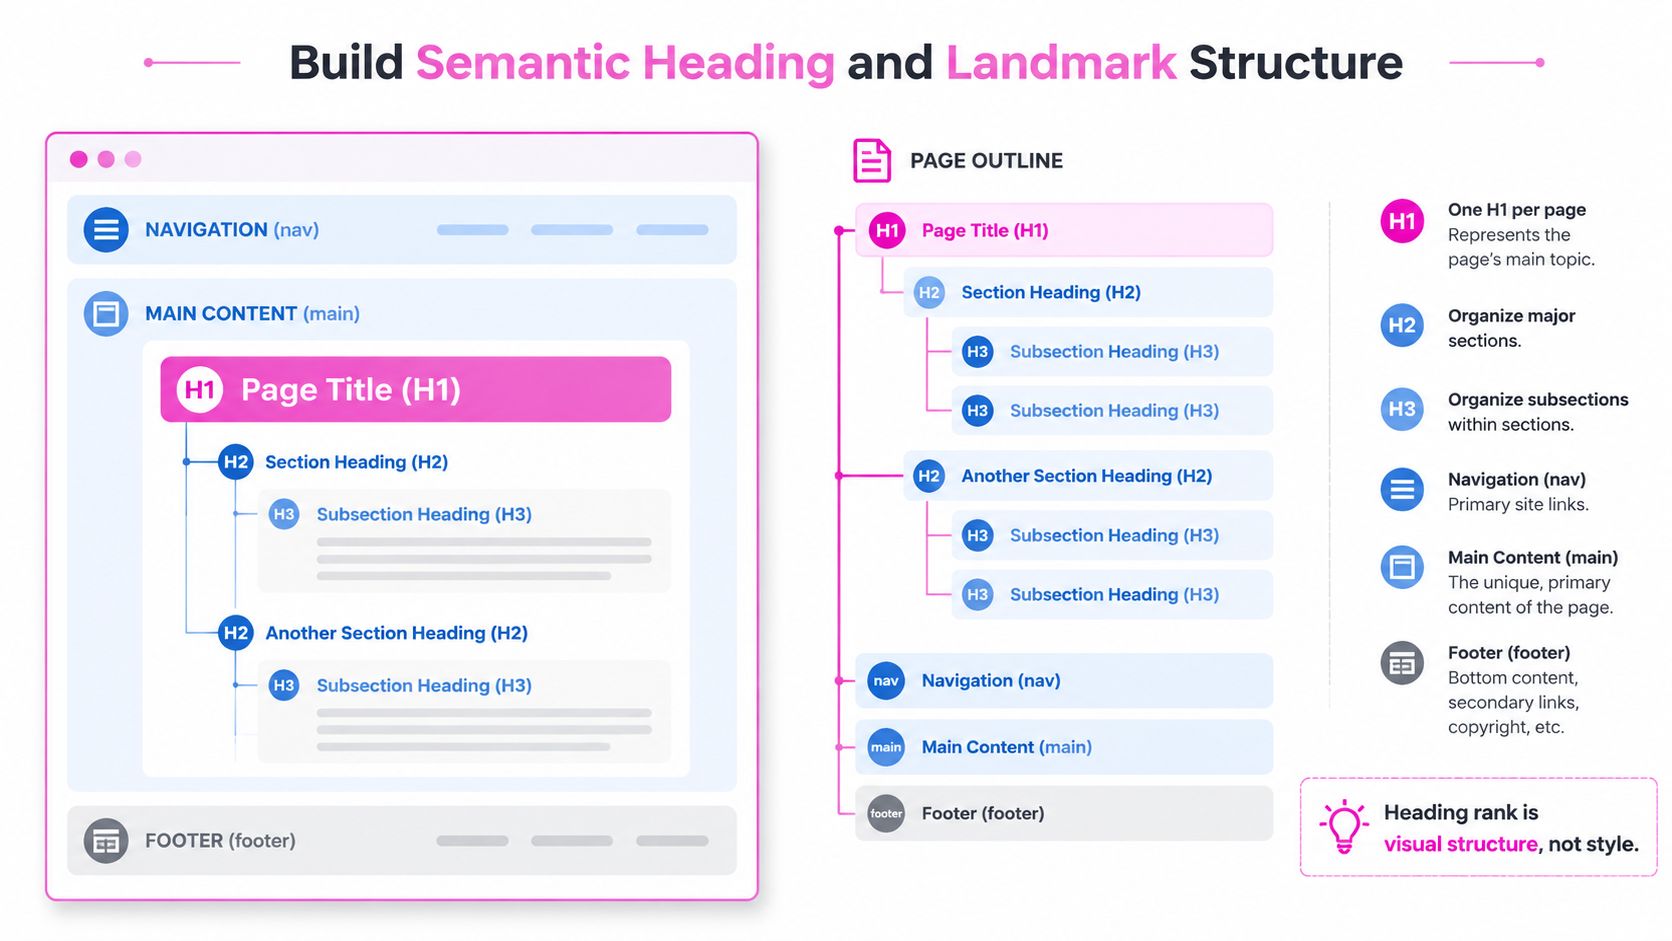
Traktuję szablon strony jako umowę między zespołem ds. treści, przeglądarką, technologiami wspomagającymi i systemami wyszukiwania. Wizualne formatowanie może sprawić, że nagłówek będzie wyglądał na widoczny, ale wygląd nie definiuje jego rangi strukturalnej. Określa go zarys dokumentu.
Implementacja zaczyna się od jednego wyraźnego nagłówka strony, po którym następują sekcje odzwierciedlające rzeczywistą hierarchię treści. Sam wytyczne W3C dotyczące struktury nagłówków stwierdzają, że hierarchia nagłówków powinna być semantyczna, a nie wizualna. Nagłówek rangi 1 jest najważniejszym nagłówkiem, nagłówki o równych lub wyższych rangach rozpoczynają nowe sekcje, a niższe rangi tworzą podsekcje.
Szkielet szablonu, którego używam
Nie przeskakuję z nagłówka h2 do h4, ponieważ projektant chce mniejszego wizualnego potraktowania. Zmieniam CSS, a nie semantyczną rangę. Strona produktu może wyglądać tak:
- H1: Nazwa produktu i główny cel
- H2: Korzyści lub przypadki użycia
- H2: Specyfikacje
- H3: Wymiary
- H3: Materiały
- H2: Dostawa i wsparcie
- H2: Często zadawane pytania
Taka struktura daje redaktorom powtarzalny wzorzec i czytnikom ekranu logiczną ścieżkę przez stronę. Dla zespołów produktowych pracujących nad treścią i szczegółami konwersji, te najlepsze praktyki dotyczące stron szczegółów produktu stanowią przydatne uzupełniające wskazówki.
Znaczniki dodają drugi poziom do struktury. Używam nagłówka (header) do identyfikacji witryny i sterowania, nawigacji (nav) do głównej nawigacji, jednego elementu głównego (main) do unikalnej zawartości strony, elementu pobocznego (aside) do materiałów uzupełniających i stopki (footer) do informacji końcowych witryny. Wskazówki dotyczące dostępnej architektury z zasobów kodowania znaczników AudioEye podkreślają te regiony i wymóg posiadania tylko jednego elementu głównego.
Co sprawdzam podczas implementacji
Sprawdzam wyrenderowany kod HTML, a nie tylko edytor CMS. Typowe błędy to tytuł strony renderowany jako tekst stylizowany, powtarzające się elementy h1 z komponentów wielokrotnego użytku, nawigacja wstawiona w treść główną i widżety paska bocznego oznaczone jako sekcje główne.
Testuję również nawigację za pomocą klawiatury i zarys czytnika ekranu. Jeśli użytkownik nie może pominąć powtarzającej się nawigacji lub szybko zidentyfikować głównej treści, szablon ma problem ze strukturą, nawet jeśli strona wygląda na dopracowaną.
Projektowanie struktury adresów URL i silosów tematycznych
Foldery adresów URL same w sobie nie tworzą autorytetu tematycznego. Używam ich do wyrażania istniejących relacji w modelu treści, a nie do symulowania trafności poprzez dekoracyjne zagnieżdżanie.
Przy dużej budowie katalogu, zmapowałem 4000 stron na grupy produktów, aplikacji, branż i wsparcia. Przydatna część to nie było nazywanie folderów. Chodziło o zdecydowanie, które strony odpowiadały na konkretne intencje, a które po prostu powtarzały ten sam język handlowy. Krótkie, statyczne, opisowe adresy URL uwidaczniały te decyzje, podczas gdy długie ciągi parametrów je ukrywały.
Buduj wokół encji i intencji
Praktyczny klastra może wyglądać tak:
/software/jako szeroki hub kategorii/software/project-management/jako hub zorientowany na intencję/software/project-management/features/dla informacji na poziomie funkcji/software/project-management/integrations/dla powiązanych narzędzi/software/project-management/use-cases/remote-teams/dla wyspecjalizowanego przypadku użycia
Nie zmuszam każdego podrzędnego elementu do wchodzenia w ścieżkę URL, która odzwierciedla każdą relację nadrzędną. Strona może znajdować się w głębszym klastrze tematycznym, pozostając jednocześnie technicznym osiągalna za pomocą zwięzłego adresu URL. Folder powinien pomagać użytkownikom i systemom zrozumieć temat, ale nie powinien stawać się zamiennikiem linkowania wewnętrznego.
The wskazówki dotyczące badań słów kluczowych i klastrów tematycznych jest przydatne do oddzielania grup zapytań przed tworzeniem stron. Zaczynam od intencji, relacji między encjami i własności treści. Następnie decyduję, czy witryna potrzebuje osobnej strony, podsekcji, czy w ogóle nowego URL-a.
Gdzie silosowanie zawodzi
Moje pierwsze mapy silosów były zbyt sztywne. Zasób mógł należeć do branży, funkcji oraz zadania do wykonania (job-to-be-done), ale architektura pozwalała tylko na jednego rodzica. Redaktorzy tworzyli duplikaty stron, aby zadowolić konkurujące zespoły, a te strony pokrywały się na tyle, że myliły zarówno użytkowników, jak i wyszukiwarki.
Obecnie stosuję klasyfikację główną oraz linki wewnętrzne tam, gdzie relacje mają znaczenie. Scalam sekcje, gdy są skierowane na tę samą intencję, dzielą tę samą ścieżkę konwersji i nie mogą zaoferować unikalnych informacji. Rozdzielam je, gdy odbiorcy, zadanie, dowody lub decyzja produktowa są inne.
Płytka ścieżka URL może wspierać efektywne odkrywanie bez spłaszczania hierarchii treści. Ważne pytanie brzmi, czy każdy adres URL ma jasną rolę i celową ścieżkę przez graf linków.
Zastosuj regułę linkowania wewnętrznego, która działa
Nawigacja wewnętrzna zawodzi, gdy zespoły traktują główne menu jako całą strategię linkowania. Strona może pojawić się w menu rozwijanym, a mimo to nie mieć znaczącego związku z otaczającą treścią. Wyszukiwarki i użytkownicy potrzebują linków kontekstowych, które wyjaśniają, dlaczego jedna strona prowadzi do drugiej.
Moja zasada działania jest prosta: każda ważna strona powinna otrzymać co najmniej pięć linków wewnętrznych ze stron powiązanych, a każda ważna strona na głębokości indeksowania 4 lub więcej wymaga uwagi, zgodnie z tymi wytycznymi dotyczącymi budżetu indeksowania linków wewnętrznych.
Miesięczny przepływ pracy
Zaczynam od eksportu z indeksowania i porównania mapy witryny. Indeksowanie mówi mi, co witryna udostępnia poprzez linki. Mapa witryny mówi mi, co organizacja uważa za godne odkrycia. Różnice zazwyczaj ujawniają jeden z czterech problemów:
- Porzucone strony: Adresy URL wymienione w mapie witryny, ale niedostępne poprzez linki wewnętrzne.
- Strony dostępne tylko z nawigacji: Adresy URL połączone z globalnego menu, ale nieobecne w odpowiedniej treści głównej.
- Głęboko ukryte ważne strony: Strony komercyjne lub strategiczne ukryte za kilkoma pośrednimi krokami.
- Nieprawidłowe ścieżki: Łańcuchy przekierowań, zwłaszcza łańcuchy z dwoma lub więcej przeskokami, które osłabiają ścieżkę i komplikują konserwację.
Następnie sortuję strony według ich znaczenia biznesowego i sprawdzam źródła linków przychodzących. Strona z pięcioma linkami z niepowiązanych modułów stopki nie spełnia ducha zasady. Chcę linków ze stron, które dzielą temat, odpowiadają na poprzednie pytanie lub kierują użytkownika do sensownego następnego kroku.
Link powinien wyjaśniać relację, a nie tylko udowadniać, że istnieją dwa adresy URL.
Napraw wykres, nie tylko stronę
Dla strony usługi bez powiązań, mogę dodać linki z odpowiedniego centrum usług, powiązanych artykułów o przypadkach użycia, strony porównawczej i zasobu pomocy technicznej. Dla strony archiwum mogę wzmocnić główny hub i dodać nawigację według daty lub tematu, zamiast wpychać archiwum do głównego menu.
Sprawdzam również dokładność tekstu zakotwiczenia. Powtarzanie jednego komercyjnego zwrotu wszędzie wygląda mechanicznie i daje użytkownikom mało kontekstu. Opisowa odmiana działa lepiej, ponieważ odzwierciedla rzeczywistą relację między stronami źródłowymi a docelowymi.
Ostatnim krokiem jest ponowne przeszukanie. Nie oznaczam zgłoszenia jako zakończonego, ponieważ programista dodał link w szablonie. Potwierdzam, że wyrenderowana strona zawiera link, strona docelowa zwraca zamierzoną odpowiedź, a trasa pojawia się na wynikowym wykresie przeszukiwania.
Nie umieszczaj krytycznych treści w kolejce renderowania
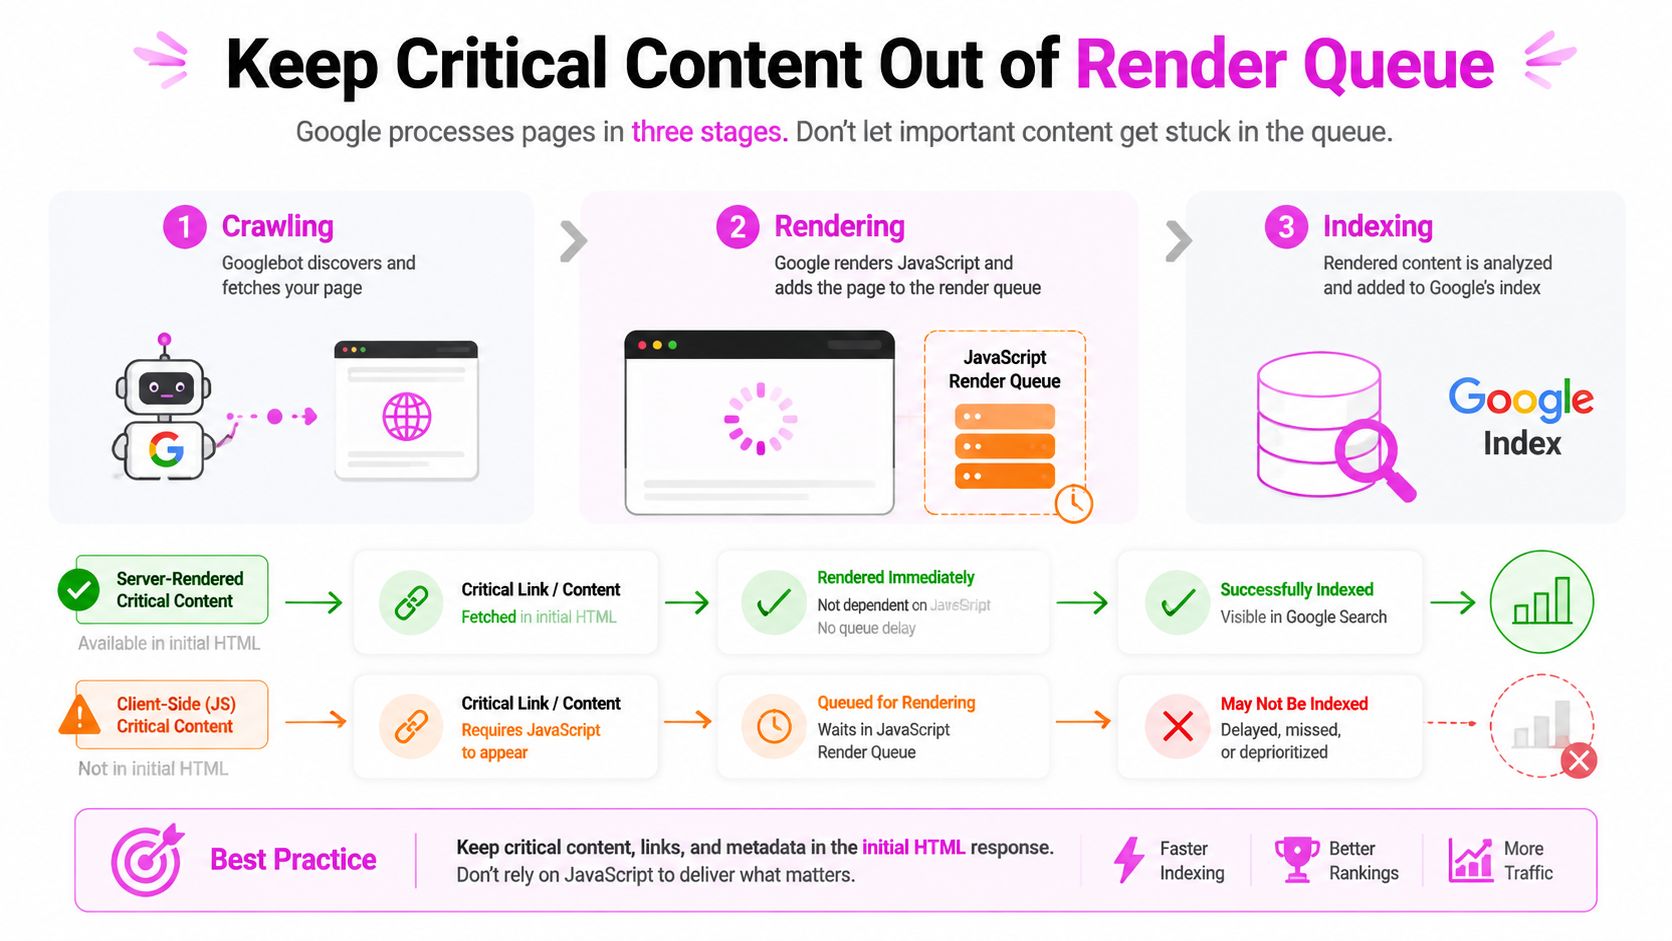
Google przetwarza strony JavaScript poprzez przeszukiwanie, renderowanie i indeksowanie, zgodnie z dokumentacją w podstawach SEO JavaScript. Ta "pipeline" nie oznacza, że strony renderowane po stronie klienta są automatycznie niewidoczne. Oznacza to, że architektura zależna od późnego wykonania wprowadza kolejny krok przetwarzania między odkryciem a oceną.
Dowiedziałem się tego podczas przebudowy strony renderowanej po stronie klienta, gdzie początkowy kod HTML zawierał "szkielet", podczas gdy ważne linki i opisy produktów pojawiały się dopiero po uruchomieniu JavaScript. Strona działała idealnie w przeglądarce, ale warstwa źródłowa widoczna dla wyszukiwarek nie zawierała tej samej struktury. To znacznie utrudniło debugowanie, ponieważ udane renderowanie wizualne maskowało niekompletną warstwę dostarczania.
Umieść ważne sygnały w kodzie HTML serwera
Dla stron, gdzie ważna jest możliwość odkrycia, preferuję renderowanie po stronie serwera, generowanie statyczne lub podejście hybrydowe. Początkowa odpowiedź powinna zawierać:
- Główna treść: Tekst, który określa, na jakie pytanie odpowiada strona.
- Krytyczne linki wewnętrzne: Linki do powiązanych stron, głównych sekcji i ważnych stron komercyjnych.
- Sygnały kanoniczne: Preferowany adres URL powinien być jasny bez oczekiwania na kod po stronie klienta.
- Dane strukturalne: Szczegóły czytelne dla maszyn powinny być obecne w dostarczonym dokumencie, gdy jest to właściwe.
Nie zakazuje to JavaScript. Filtry, personalizacja, interaktywne porównania i ulepszenia progresywne mogą nadal działać po stronie klienta. Oddzielam te udogodnienia od treści i linków, które wyszukiwarki muszą niezawodnie odkrywać.
Uwzględnij zmienność czasu
Kwalifikujące się strony zwracające kod HTTP 200 są zazwyczaj umieszczane w kolejce do renderowania. Jeden z zestawów danych z 2024 r. zgłosił średnie opóźnienie wynoszące około 10 sekund między indeksowaniem a ukończonym renderowaniem, podczas gdy najwolniejsze 1% czekało około 18 godzin. Te liczby pochodzą z niezależnych raportów na temat renderowania SEO JavaScript, i ilustrują, dlaczego średnie zachowanie nie wystarcza dla krytycznych adresów URL.
Praktyczna reakcja to nie panika. To redukcja ryzyka. Jeśli strona zawiera ofertę ograniczoną czasowo, nowo opublikowany hub lub ścieżkę linków do ważnych zasobów, nie uzależniam jej istnienia od kolejki renderowania.
Po wdrożeniu porównuję kod HTML źródłowy z wyrenderowanym kodem HTML, sprawdzam linki w obu stanach i testuję dane kanoniczne oraz dane strukturalne. Strona, która wygląda poprawnie w Chrome, nadal może mieć wadę architektoniczną w pierwszej odpowiedzi.
Audyt budżetu indeksowania i luki w bezpiecznym dostarczaniu
Google definiuje budżet indeksowania jako adresy URL, które może i chce indeksować, łącząc pojemność indeksowania z zapotrzebowaniem na indeksowanie w swojej dokumentacji dotyczącej budżetu indeksowania. Ta definicja zmienia sposób, w jaki audytuję duże witryny. Nie staram się, aby każdy adres URL był równie łatwy do zaindeksowania. Redukuję nieefektywne ścieżki i ułatwiam dotarcie do ważnych miejsc.
Paginacja i nawigacja fasetowa to częste źródła marnotrawstwa. Witryna detaliczna może udostępniać kombinacje filtrów, które generują niemal identyczne strony, podczas gdy archiwum redakcyjne może tworzyć wiele wariantów parametrów o niewielkiej samodzielnej wartości. Mapuję, które kombinacje zasługują na adresy URL nadające się do indeksowania, które powinny pozostać stanami nawigacyjnymi, a które powinny zostać skonsolidowane.
Arkusz audytu
Priorytetyzuję ustalenia, zadając cztery pytania:
| Obszar audytu | Co sprawdzam | Typowa decyzja |
|---|---|---|
| Dostępność stron | Czy ważne adresy URL są dostępne poprzez odpowiednie centra? | Dodaj linki kontekstowe lub popraw strukturę centrum |
| Ścieżki fasetowe | Czy filtry tworzą użyteczne, odrębne miejsca docelowe? | Zachowaj wybrane kombinacje, kontroluj resztę |
| Paginacja | Czy każda trasa archiwum dodaje treści, które można odkryć? | Utrzymuj użyteczne ścieżki i usuwaj niepotrzebne warianty |
| Bezpieczeństwo dostarczania | Czy witryna konsekwentnie udostępnia bezpieczne wersje? | Rozwiąż mieszane wzorce dostarczania strukturalnego |
Raport SEO HTTP Archive z 2025 roku odnotował użycie HTTPS na poziomie 91,7% stron na komputery stacjonarne i 91,5% stron mobilnych, w porównaniu do około 89% na wszystkich urządzeniach w 2024 roku. Ten sam raport wykazał, że strony główne rzadziej korzystają z HTTPS niż strony wewnętrzne, 84,64% w porównaniu do 92,42% na komputerach stacjonarnych i 86,64% w porównaniu do 93,45% na urządzeniach mobilnych. Te dane pojawiają się w odniesieniu do budżetu indeksowania i są przydatne jako sygnał audytu, ponieważ jedna witryna może zawierać różne wzorce dostarczania w zależności od typu strony.
Połącz kontrolki techniczne z intencją
Analizuję dyrektywy robots, kanonikalizację, mapy witryn, przekierowania i linki wewnętrzne jako jeden system. Dyrektywa noindex może być odpowiednia dla stanu filtra o niskiej wartości, ale intensywne linkowanie do tego stanu marnuje uwagę. Kanonikalizacja może konsolidować duplikaty, ale nie powinna zastępować jasnego modelu adresów URL.
Aby uzyskać skoncentrowane odniesienie do kontrolowania dyrektyw indeksowania, używam tego przewodnika do tag meta robots. Następnie weryfikuję implementację podczas indeksowania i porównuję ją ze stronami, które firma chce, aby użytkownicy i wyszukiwarki znalazły.
Struktura dla przeglądów AI, nie tylko niebieskich linków
Klasyczna architektura pyta, czy robot może znaleźć stronę i czy ta strona może się pozycjonować. Wyszukiwanie generatywne dodaje kolejne pytanie: czy system może wyodrębnić zaufaną, samodzielną odpowiedź ze strony i połączyć ją z właściwym bytem?
Obecny zakres opisuje przesunięcie w kierunku stron czytelnych dla AI, gotowych do odpowiedzi, podczas gdy wiele porad nadal powtarza hierarchię, linkowanie wewnętrzne i schematy, nie pokazując, które wzorce stron zdobywają cytaty. Tę lukę podkreślono w dyskusji Search Engine Land na temat wpływu SEO i AI.
Porównaj trzy wzorce
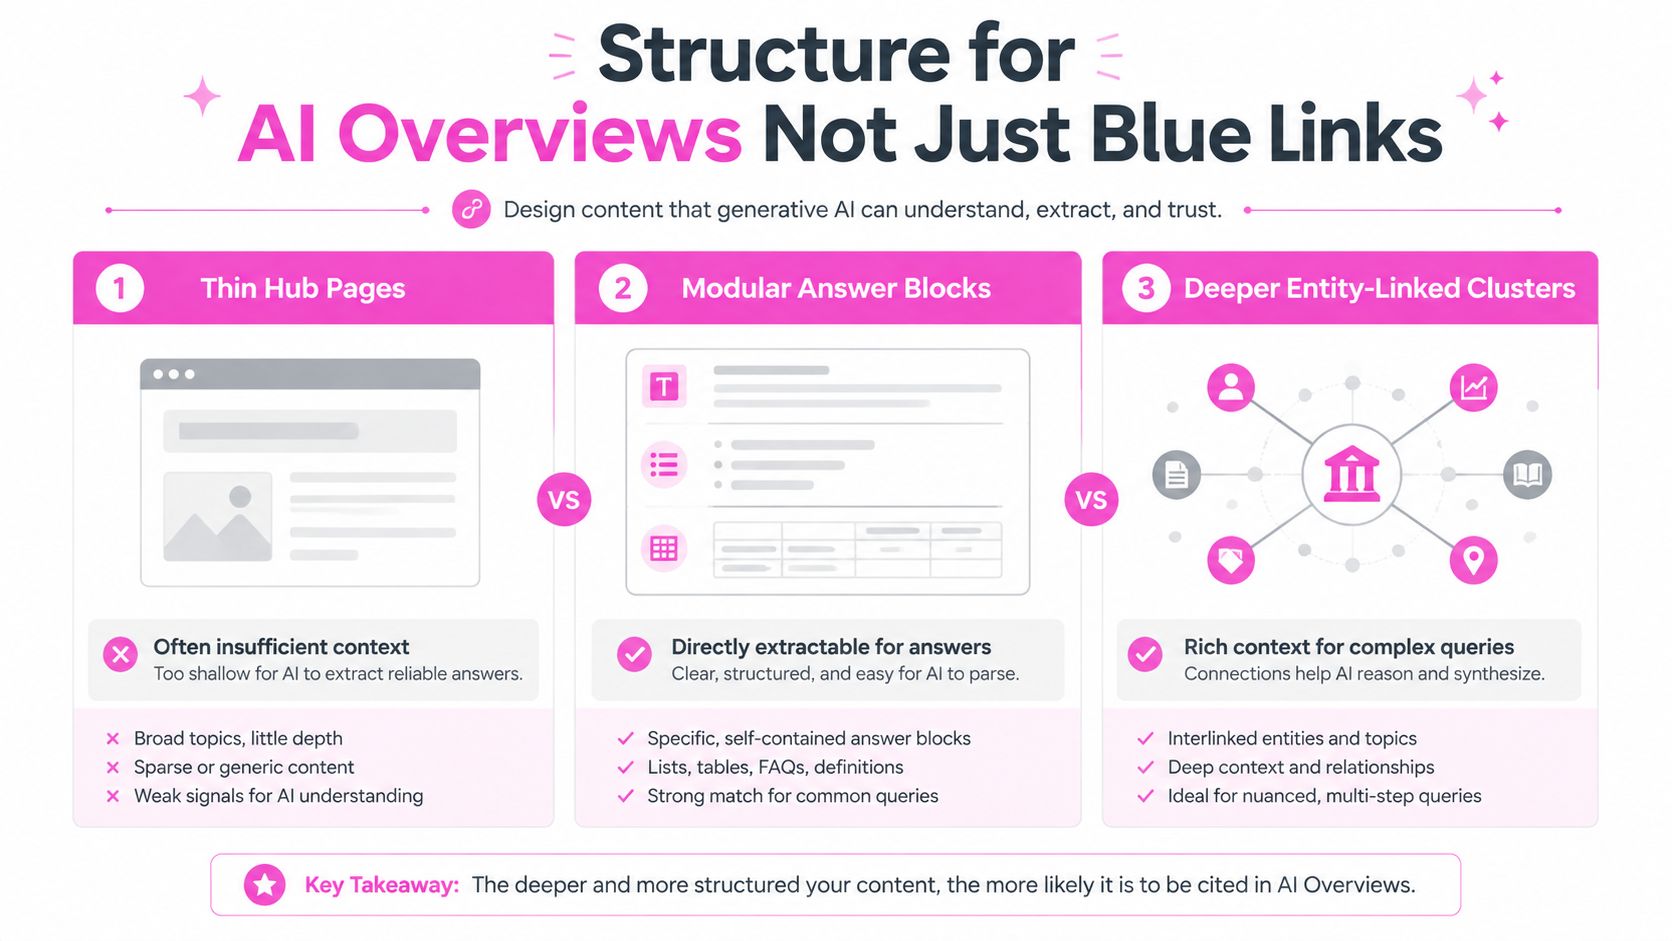
Cienkie strony-huby są łatwe do zaindeksowania, ale często brakuje im wystarczającego kontekstu, aby wesprzeć złożoną odpowiedź. Używam ich tylko wtedy, gdy hub kieruje użytkowników do szczegółowych informacji i sam odpowiada na ogólny zamiar.
Modułowe bloki odpowiedzi działają dobrze, gdy strona musi jasno odpowiadać na różne pytania. Definicja, wyjaśnienie kwalifikowalności, porównanie, proces lub ograniczenie mogą istnieć samodzielnie, pozostając jednocześnie powiązane z szerszą stroną. Taka struktura zapewnia systemom ekstrakcji wyraźniejsze granice, nie zamieniając strony w niepołączone fragmenty.
Głębsze klastry powiązane z encjami pasują do złożonych tematów, gdzie jedna strona nie może ustalić wszystkich powiązań. Centralna strona encji może linkować do atrybutów, przypadków użycia, alternatyw, dowodów i dokumentacji pomocniczej. Głębokość dodaje wartości, gdy każda strona podrzędna dostarcza odrębnych informacji.
Moje testy zaczynają się od typu zapytania, a nie od preferowanego szablonu. Porównuję, które adresy URL pojawiają się dla podpowiedzi AI Overview, sprawdzam cytowane sekcje stron i szukam wzorców w kompletności odpowiedzi, jasności encji i linkach pomocniczych. W przypadku implementacji danych strukturalnych, trzymam to odniesienie na dane strukturalne dla SEO w pobliżu, ale nie mylę znacznika z substytutem użytecznej treści strony.
Modularna strona może wspierać zarówno widoczność niebieskich linków, jak i cytowanie, jeśli ma jasny temat, precyzyjne odpowiedzi, widoczne dowody i linki, które ustalają otaczający temat. Cienka strona-hub może być technicznie czysta i nadal dostarczać zbyt mało treści.
Czego nauczyłem się, przebudowując stronę z 20 tysiącami stron
Migracja, która zmieniła mój proces, obejmowała stronę z 20 tysiącami stron z zerwanymi silosami, osieroconymi fasetami i hubami renderowanymi po stronie klienta. Strona miała mnóstwo treści, ale architektura nie komunikowała priorytetów. Ważne nagłówki klastrów znajdowały się za słabymi ścieżkami, podczas gdy adresy URL filtrów konkurowały ze stronami, które miały nieść intencję komercyjną.
Zacząłem od klasyfikowania adresów URL według ich roli, a nie według folderu, w którym się znajdowały. Rozdzieliliśmy strony docelowe (money pages), nagłówki klastrów, zasoby pomocnicze i głębokie archiwa. Miejsca krytyczne dla przychodów zostały zbliżone do odpowiednich hubów, podczas gdy specjalistyczne treści archiwalne zachowały głębię i zyskały silniejsze linki nadrzędne i siostrzane.
Decyzje dotyczące przebudowy
Zastąpiliśmy nagłówki wyłącznie wizualne semantyczną strukturą szablonu i wprowadziliśmy spójne regiony nawigacyjne. Zespół zastosował również minimum pięciu linków do ważnych stron, a następnie wykorzystał dane z indeksowania do znalezienia osieroconych adresów URL i łańcuchów przekierowań, zamiast polegać na przeglądach nawigacji.
Najważniejszą techniczną zmianą było przeniesienie treści stron docelowych (money pages), linków wewnętrznych, sygnałów kanonicznych i danych strukturalnych do kodu HTML dostarczanego przez serwer. Interakcje po stronie klienta pozostały, ale strona nie była już od nich zależna pod względem podstawowego znaczenia SEO.
Drogim błędem było traktowanie każdego zaindeksowanego adresu URL jako równie wartościowego.
Połączyliśmy również nakładające się huby zamiast tworzyć kolejną warstwę kategorii. To zmniejszyło duplikację w architekturze informacji i nadało pozostałym hubom jaśniejszy cel. Zrobiłbym tę klasyfikację wcześniej. Zbyt długo debatowaliśmy nad nazwami folderów, zanim zgodziliśmy się, które strony zasługują na istnienie.
Wynik i lekcja
Głowy klastrów odzyskały swoje pozycje w ciągu dwóch kwartałów, a indeksowanie głębokich archiwów ustabilizowało się. Te wyniki były wynikiem kilku skoordynowanych zmian, a nie spłaszczenia strony lub dodania pojedynczego tagu technicznego. Przydatną lekcją było operacyjne podejście: architektura wymaga własności, monitorowania i powtarzalnej walidacji po uruchomieniu.
Teraz analizuję ścieżki indeksowania, pokrycie mapy witryny, wyniki renderowania, linki wewnętrzne i cel strony razem. Witryna może mieć czyste adresy URL, a mimo to marnować zapotrzebowanie na indeksowanie. Może mieć doskonałe treści, a mimo to ukrywać je za słabym grafem linków. Może renderować się pięknie, a mimo to dostarczać niewłaściwą pierwszą odpowiedź.
Architektura strony internetowej działa wtedy, gdy te systemy są zgodne co do tego, co ma znaczenie.
SemDash może pomóc Ci w mapowaniu intencji słów kluczowych na klastry na poziomie stron, porównywaniu adresów URL konkurencji, analizowaniu możliwości linkowania wewnętrznego oraz śledzeniu, które adresy URL otrzymują cytowania w AI Overview. Odwiedź SemDash (SemDash) aby połączyć swoje decyzje dotyczące architektury z aktualnymi danymi z wyników wyszukiwania (SERP), słów kluczowych, linków zwrotnych i cytowań.