Większość porad dotyczących dane strukturalne dla SEO zaczyna się od „dodaj schemat i zdobądź wyniki rozszerzone”. To właśnie ta część powoduje najwięcej zmarnowanej pracy. Widziałem zespoły wdrażające znaczniki Organizacja, Artykuł, BreadcrumbList i Produkt na tysiącach adresów URL, a następnie czekające na widoczną zmianę, która nigdy się nie pojawiła.
Wdrożenie niekoniecznie było bezużyteczne. Model pomiaru był niekompletny. Dane strukturalne mogą sprawić, że treść będzie zrozumiała dla wyszukiwarek, wspierać kwalifikację do wyników rozszerzonych, wyjaśniać relacje między jednostkami i ujawniać błędy implementacji na całej stronie. Dokumentacja Google jasno stanowi, że dane strukturalne nie są bezpośrednim czynnikiem rankingowym, ale mogą pomóc wyszukiwarce zrozumieć stronę i określić, czy strona kwalifikuje się do bardziej rozszerzonego formatu wyników, jak wyjaśniono w Wprowadzenie do danych strukturalnych Google.
Praktyczne pytanie brzmi nie „Czy wkleiliśmy schemat do szablonu?”. Brzmi ono „Co wyszukiwarka może pewnie zrozumieć, zweryfikować i wykorzystać ze strony?”
Spis treści
- Co dane strukturalne faktycznie robią na żywej stronie
- Znaczniki schematu wyjaśnione bez żargonu
- Typy schematów, na które warto poświęcić czas w 2026 roku
- Wybór formatu i prawidłowe oznaczanie danych
- Pokrycie to prawdziwy problem, a nie obecność
- Testowanie, debugowanie i monitorowanie danych strukturalnych
- Wykorzystanie narzędzi do badań SEO do ustalania priorytetów prac nad schematem
- Twoja lista kontrolna danych strukturalnych i co dalej
Co dane strukturalne faktycznie robią na żywej stronie
Wdrożenie u jednego wydawcy zespół zaimplementował kilka typów schematów w dużej bibliotece treści. Znacznik był obecny, szablony się renderowały, a deweloperzy uznali projekt za zakończony. Wyniki rozszerzone nie pojawiły się w sposób, w jaki oczekiwali interesariusze, więc projekt początkowo został określony jako porażka.
Nie zgodziłem się z tym wnioskiem, ale też nie nazwałbym wdrożenia udanym. Zespół traktował dane strukturalne jako jedno zadanie, podczas gdy wykonywały one co najmniej trzy różne zadania z bardzo różnymi kryteriami sukcesu.
Oznacza encje zamiast zgadywać
Pierwszym zadaniem jest identyfikacja encji. Strona może wspominać o marce, produkcie, autorze, praktyce medycznej lub temacie recenzji, którego nazwa przypomina inne jednostki w sieci. Schemat nadaje maszynom jasne etykiety, takie jak Organization, Produkt, Osoba, Article, a Review.
To nie udowadnia magicznie każdego stwierdzenia na stronie. Tworzy jednak wyraźniejszą warstwę danych. A Article może wskazywać na Osoba autora, a Produkt może wskazywać na Offer, a Organization może łączyć się z profilami autorytatywnymi poprzez sameAs. Te relacje są bardziej użyteczne niż płaski blok, który tylko powtarza tytuł strony.
Obsługuje interpretację maszynową poza SERP
Drugie zadanie jest mniej widoczne. Dane strukturalne mogą pomóc systemom zinterpretować, o czym jest strona, nawet jeśli w wynikach wyszukiwania nie pojawia się żadne wizualne ulepszenie. Ma to znaczenie, ponieważ interfejsy wyszukiwania coraz częściej podsumowują, porównują i odpowiadają, zamiast wyświetlać tylko dziesięć niebieskich linków.
Nie traktuję schematu jako gwarantowanej drogi do odpowiedzi generowanych przez AI. Żadne znaczniki nie mogą zmusić systemu do cytowania strony. Traktuję to jako sposób na zmniejszenie niejednoznaczności, zwłaszcza gdy strona zawiera powiązane encje, jasne autorstwo, daty, produkty lub informacje o organizacji.
Ujawnia problemy z jakością
Trzecim zadaniem jest operacyjne. Czyste znaczniki zmuszają zespół do odpowiedzi na niewygodne pytania. Kto napisał artykuł? Który obraz reprezentuje produkt? Czy wyświetlana cena jest taka sama jak cena ustrukturyzowana? Czy ścieżka nawigacyjna odzwierciedla rzeczywistą hierarchię?
Praktyczna zasada: Dane ustrukturyzowane powinny opisywać stronę, którą otrzymują użytkownicy, a nie wynik, który masz nadzieję wyświetlić Google.
Po tym, jak wydawca zmienił swój proces przeglądu z „Czy skrypt jest obecny?” na „Czy silnik potrafi przeanalizować zamierzone encje i relacje?”, zespół odkrył niespójności w szablonach, które umknęły zwykłym kontrolom SEO. Ta zmiana stanowi podstawę do oceny typów schematów pod kątem rzeczywistej wartości biznesowej, a nie pod kątem tego, jak imponująco wdrożenie wygląda w kodzie źródłowym.
Znaczniki schematu wyjaśnione bez żargonu
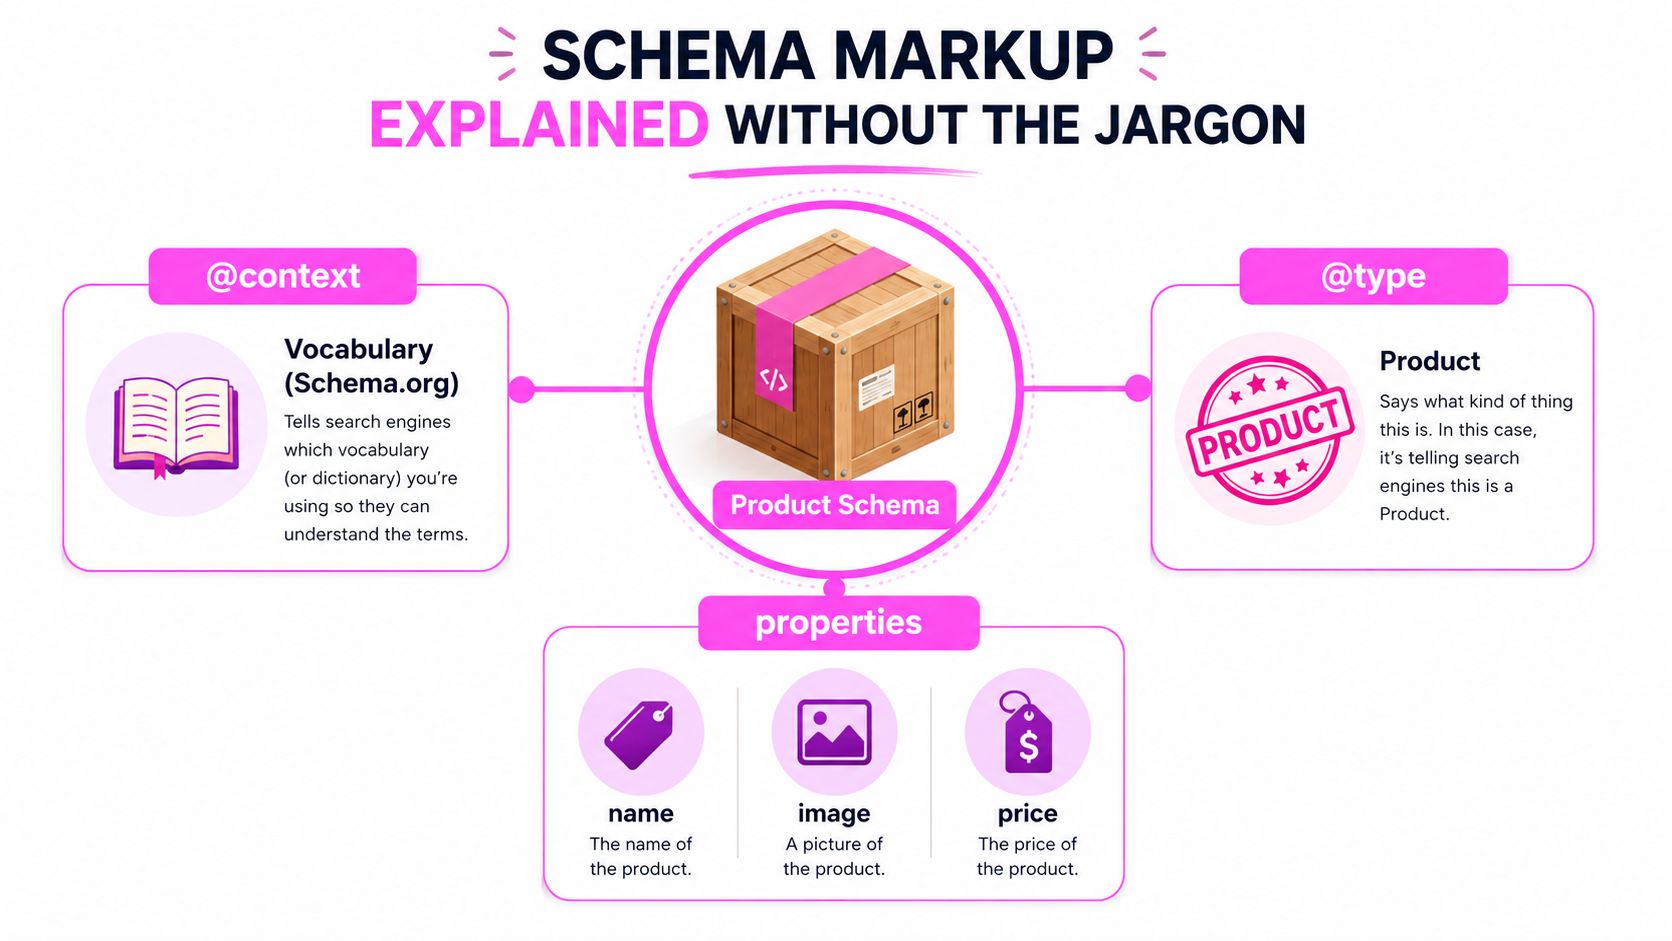
Pomyśl o bloku schematu jak o skrzyni transportowej z etykietami. Skrzynia zawiera informacje o jednej rzeczy lub kilku powiązanych rzeczach. Etykiety zewnętrzne informują maszynę, jakiego słownictwa używasz i jaki rodzaj obiektu otrzymała.
@contextidentyfikuje słownictwo, zazwyczaj Schema.org.@typeidentyfikuje rzecz, taką jakArticle,Produkt, lubOrganization.- Właściwości identyfikują jej części, takie jak
name,image,author, lubprice.
Minimalny obiekt artykułu może wyglądać koncepcyjnie tak:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "A Practical Guide to Structured Data"
}
</script>
Typ informuje parser, że jest to artykuł. Nagłówek nadaje mu nazwę właściwości. To wystarczy, aby zrozumieć podstawowy kształt, ale produkcyjny znacznik zazwyczaj wymaga więcej kontekstu:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "A Practical Guide to Structured Data",
  "author": {
    "@type": "Person",
    "name": "Alex Morgan"
  },
  "datePublished": "2026-08-20",
  "image": "https://example.com/images/structured-data.jpg"
}
</script>
Zagnieżdżony author obiekt ma znaczenie, ponieważ autor jest osobą, a nie tylko niekwalifikowanym ciągiem tekstowym. To rozróżnienie pozwala systemowi zrozumieć relację między artykułem a jego twórcą.
Dlaczego JSON-LD jest zazwyczaj moim domyślnym wyborem
Google zaleca JSON-LD jako preferowany format danych strukturalnych. Format ten znajduje się w elemencie skryptu, oddzielnie od widocznego kodu HTML, dzięki czemu inżynierowie mogą generować go z pól CMS bez przeplatania atrybutów przez każdy element treści. Galeria danych strukturalnych Google opisuje również JSON-LD jako zalecany format umieszczany w nagłówku lub treści.
Mikrodane i RDFa mogą działać, ale ściślej wiążą metadane z kodem strony. Zwiększa to ryzyko konserwacji, gdy projektanci zmieniają strukturę HTML lub nazwy komponentów. Dla zespołów, które tworzą szablony schematów dla wielu adresów URL, separacja ułatwia audyt i wdrażanie.
Częste błędy są łatwe do rozpoznania:
- Brakuje wymaganego pola, więc element może nie kwalifikować się do wyświetlenia jako bogaty wynik.
- A
Produktjest zadeklarowane jakoArticle, więc właściwości opisują niewłaściwy podmiot. - Zagnieżdżony obiekt jest zredukowany do ciągu znaków, na przykład nazwa autora bez identyfikacji autora jako
Osoba. - Cena, recenzja lub data w JSON-LD nie zgadzają się z tym, co widzą użytkownicy.
Schemat to metadane, a nie treść. Powinien wyjaśniać widoczną treść i relacje. Nie powinien wprowadzać twierdzeń, ofert, recenzji ani odpowiedzi, których strona nie obsługuje. Jeśli Twoja praca polega na uczynieniu bytów zrozumiałymi w złożonych branżach, ten praktyczny przewodnik po SEO dla praktyk medycznych zorientowane na AI jest użytecznym towarzyszem, ponieważ jasność encji staje się szczególnie ważna, gdy usługi, praktycy i lokalizacje się nakładają.
Typy schematów, na które warto poświęcić czas w 2026 roku
Szereguje typy schematów według wyników, które mogą wspierać, a nie według tego, jak często wtyczka je oferuje. Dokumentacja Google jasno rozróżnia: dane strukturalne mogą umożliwiać bogate wyniki, ale same w sobie nie są bezpośrednim sygnałem rankingowym. Typ ma znaczenie tylko wtedy, gdy strona jest kwalifikowalna, oznaczenie jest dokładne, a środowisko wyszukiwania nadal wyświetla tę funkcję.
| Typ Schematu | Bogaty Wynik w 2026? | Główna Wartość SEO | Częsty Błąd |
|---|---|---|---|
| Produkt z Ofertą | Tak, tam gdzie to możliwe | Widoczność produktu, cena, dostępność i kontekst komercyjny | Emitowanie nieaktualnych lub pustych pól oferty |
| Recenzja lub AggregateRating | Tak, tam gdzie to możliwe | Prezentacja recenzji i kontekst zaufania | Oznaczanie recenzji, które nie spełniają wymagań polityki |
| Przepis | Tak, tam gdzie to możliwe | Prezentacja wyszukiwania specyficzna dla przepisów | Stosowanie pól przepisu do ogólnych artykułów o żywności |
| Wydarzenie | Tak, tam gdzie to możliwe | Daty, lokalizacje i odkrywanie wydarzeń | Pozostawianie aktywnych anulowanych lub wygasłych wydarzeń |
| LocalBusiness | Tak, tam gdzie to możliwe | Tożsamość firmy, lokalizacja i kontekst usług | Używanie jednego ogólnego obiektu firmy dla każdej lokalizacji |
| JobPosting | Tak, tam gdzie to możliwe | Widoczność ofert pracy | Utrzymywanie aktywnych wypełnionych lub wygasłych stanowisk |
| VideoObject | Tak, tam gdzie to możliwe | Odkrywanie filmów i ulepszona prezentacja | Brak rzeczywistego powiązania z filmem |
| Organization | Zazwyczaj pośrednie | Rozróżnianie marek i podmiotów | Niespójne nazwy, logo lub sameAs profile |
| BreadcrumbList | Zazwyczaj pośrednie | Hierarchia witryny i zrozumienie nawigacji | Generowanie ścieżek nawigacyjnych, które nie pasują do widocznej nawigacji |
| WebSite z SearchAction | Zazwyczaj pośrednie | Powiązanie wyszukiwania wewnętrznego i kontekst linków do witryny | Wskazywanie na niedziałający adres URL wyszukiwania |
| Article z autorem | Czasami kwalifikujące się | Typ treści, autorstwo i kontekst redakcyjny | Używanie autorów zastępczych lub niedokładnych dat |
| Osoba | Zazwyczaj pośrednie | Jasność autora i podmiotu eksperckiego | Tworzenie zduplikowanych podmiotów osoby dla jednego autora |
| FAQPage | Korzyść wizualna została zawężona | Maszynowo czytelne powiązania pytań i odpowiedzi | Oczekiwanie automatycznych rozwijanych bloków FAQ |
| HowTo | Korzyść wizualna została zawężona | Struktura instruktażowa i czytelność maszynowa | Dodawanie go do treści, które nie są prawdziwym poradnikiem |
Typy o wysokiej wydajności
Dla e-commerce, Produkt w połączeniu z dokładnymi Offer dane zasługują na wczesną uwagę. Implementacja musi odzwierciedlać widoczną nazwę produktu, cenę, dostępność i obraz. Przepisy, wydarzenia, lokalne firmy, oferty pracy i filmy mogą również uzasadniać skoncentrowaną pracę, gdy strona dokładnie reprezentuje daną jednostkę i spełnia udokumentowane wymagania Google.
Google's zasady dotyczące danych strukturalnych ostrzegają, że brak wymaganych właściwości może sprawić, że element będzie niekwalifikowalny. Dlatego wolę wdrożyć mniejszy zestaw kompletnych obiektów produktów niż emitować każdą możliwą właściwość z pustymi wartościami.
Typy pośrednie stają się coraz cenniejsze
Organization, Osoba, BreadcrumbList, a połączone jednostki artykułów często nie przyniosą dramatycznej zmiany wizualnej. Nadal pomagają ustalić, kto publikuje treści, jak strony pasują do witryny i które profile zewnętrzne reprezentują tę samą jednostkę.
Jestem szczególnie ostrożny z sameAs. Powinien wskazywać na autorytatywne profile reprezentujące organizację lub osobę. Nie jest to miejsce na dodawanie każdego adresu URL w mediach społecznościowych, jaki marketer może znaleźć.
FAQ i HowTo wymagają innego podejścia
Typy FAQ i HowTo zostały nadmiernie promowane, ponieważ starsze przewodniki skupiały się na rozwijanych blokach wyników wyszukiwania. Informacje o zmianach Google podają, że Google usunął bogate wyniki FAQ w dniu 7 maja 2026, po wcześniejszych ograniczeniach, podczas gdy wiele witryn nadal zachowuje znaczniki FAQPage w celu interpretacji przez maszyny. Odpowiednie informacje o zmianach w danych strukturalnych Google ramują pozostałe możliwości wokół jasności encji, wyszukiwania wewnętrznego i potencjału cytowania AI, zamiast gwarantowanej funkcji SERP.
Zachowuję znaczniki FAQ, gdy pytania i odpowiedzi są widoczne i użyteczne. Usuwam je, gdy wtyczka tworzy generyczne, zduplikowane pytania na niepowiązanych adresach URL. Decyzja jest redakcyjna i operacyjna, a nie sentymentalna.
Wybór formatu i prawidłowe oznaczanie danych
Używam domyślnie JSON-LD, ponieważ Google go poleca i oddziela dane strukturalne od kodu prezentacji. Microdata i RDFa pozostają ważnymi formatami, ale ich powiązanie z HTML utrudnia przeglądanie dużych zmian w szablonach.
| Kryterium | JSON-LD | Microdata | RDFa |
|---|---|---|---|
| Umiejscowienie | Skrypt w sekcji head lub body | Atrybuty wewnątrz kodu HTML | Atrybuty wewnątrz kodu HTML |
| Utrzymanie | Scentralizowane i przyjazne dla szablonów | Powiązane z widocznym znacznikiem | Powiązane z widocznym znacznikiem |
| Dopasowanie techniczne | Świetne dla systemów CMS i komponentowych | Przydatne, gdy metadane muszą towarzyszyć elementom | Przydatne w systemach już zbudowanych wokół RDFa |
| Audytowalność | Łatwe do wyciągnięcia i porównania | Wymaga parsowania kodu HTML strony | Wymaga parsowania kodu HTML strony |
| Domyślny wybór | Zazwyczaj moja rekomendacja | W zależności od sytuacji | W zależności od sytuacji |
Przepływ wdrożeniowy, który sprawdza się przy skalowaniu
Zaczynam od zdefiniowania modelu encji. Dla strony produktu może on obejmować Produkt, Offer, Brand, oraz wybrane informacje o recenzjach. W przypadku artykułu może to być Article, Osoba, Organization, ImageObject, oraz okruszki chleba.
Następnie mapuję każdą właściwość do zaufanego pola źródłowego:
- Wybierz źródło. Pobierz tytuł, autora, obraz, cenę i daty z pól CMS lub bazy danych produktów.
- Generuj warunkowo. Nie wypisuj pustych właściwości tylko dlatego, że biblioteka schematów je obsługuje.
- Renderuj centralnie. Umieść JSON-LD we wspólnym układzie lub komponencie strony, a nie w ręcznie pisanym tekście głównym.
- Porównaj środowiska. Utwórz różnicę schematu przedprodukcyjnego, która wyróżnia zmienione typy, identyfikator i wymagane właściwości.
- Wydawaj selektywnie. Zacznij od reprezentatywnych szablonów, a następnie rozbuduj je po walidacji.
Często używam formatera JSON, takiego jak ten darmowe narzędzie do formatowania JSON do sprawdzania wygenerowanego wyniku podczas tworzenia. To nie zastępuje narzędzi testowych Google, ale ułatwia zauważenie błędnego zagnieżdżenia i przypadkowych wartości ciągów znaków.
Problemy z polityką szkodzą bardziej niż błędy składniowe
Google twierdzi, że strony z danymi strukturalnymi muszą pozostać dostępne i ostrzega przed ich blokowaniem za pomocą robots.txt, noindex, lub inne mechanizmy kontroli dostępu. Strona musi również pokazywać informacje, które opisuje znacznik. Dane recenzji są szczególnie wrażliwe. Nie oznaczaj relacji recenzji, której widoczna strona nie popiera, i nie umieszczaj znaczników recenzji produktu na stronie zawierającej jedynie ogólne pochwały dotyczące kategorii.
Poprawny dokument JSON nadal może reprezentować niekwalifikujące się lub wprowadzające w błąd wdrożenie. Składnia to pierwsza brama, a nie ostateczna akceptacja.
Pokrycie to prawdziwy problem, a nie obecność
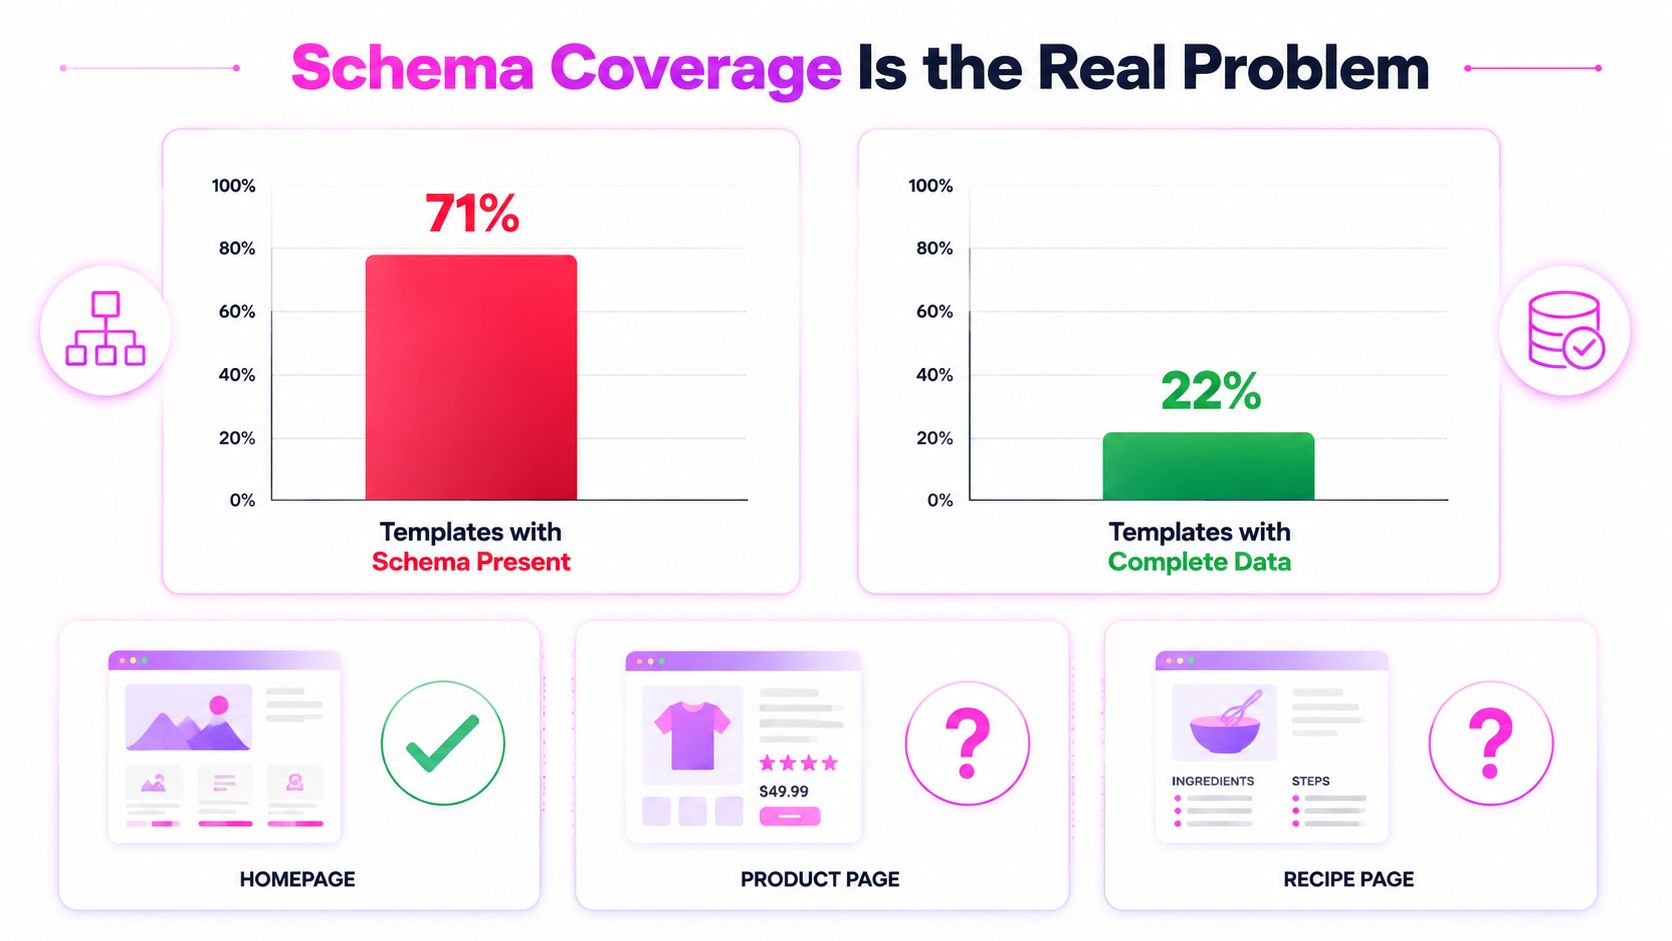
Strona główna ze schematem organizacji nie dowodzi, że Twoja witryna posiada program danych strukturalnych. Strony produktów mogą nie generować niczego. Strony z przepisami mogą wyprowadzać niekompletne obiekty. Szablony FAQ mogą tworzyć zduplikowane znaczniki z pustymi odpowiedziami. A jednak raport z systemu CMS nadal może mówić: „Schemat włączony”.
Niezależny audyt z 2026 roku wykazał, że 71% witryn używało przynajmniej jednego typu schematu, podczas gdy tylko 22% przeszło test rich results bezbłędnie dla każdego @type , który wygenerowały. Te dane są udokumentowane w audyt wdrażania i implementacji danych strukturalnych schema. Ta luka wskazuje na problem z pokryciem i jakością, a nie na brak świadomości na temat schematów.
Audytuj adresy URL, a nie szablony
Sprawdzenie na poziomie szablonu odpowiada na pytanie, czy kod istnieje. Sprawdzenie na poziomie adresu URL odpowiada na pytanie, czy kod otrzymuje pola, których potrzebuje.
Dla każdego typu schematu tworzę prosty spis:
- Adresy URL spełniające kryteria
- Adresy URL generujące zamierzony typ
- Adresy URL przechodzące walidację
- Adresy URL z ostrzeżeniami lub brakującymi właściwościami
- Adresy URL zablokowane, z tagiem noindex lub niedostępne
Następnie obliczam wskaźnik wdrożenia do uprawnienia dla każdego typu. Dokładny wskaźnik ma mniejsze znaczenie niż oddzielenie mianownika od adresów URL, które akurat mają znaczniki. Szablon produktu może być technicznie włączony, podczas gdy większość produktów nie ma zdjęć, ofert czy recenzji.
Najpierw napraw największe luki
Przeszukuję witrynę za pomocą crawlera obsługującego schematy i grupuję błędy według szablonu oraz kategorii błędu. Szablon produktu z brakującym polem ceny zasługuje na większą uwagę niż strona o małym ruchu, która idealnie wykorzystuje opcjonalny typ.
Moje priorytety to:
- Przejrzyj wszystkie kwalifikujące się klasy adresów URL.
- Grupuj adresy URL według brakującego pola i gałęzi szablonu.
- Ustaw priorytety dla stron generujących przychody oraz stron powiązanych z zapytaniami o dużej liczbie wyświetleń.
- Napraw źródła danych przed dodaniem nowych typów schematów.
- Sprawdź ponownie pokrycie po wdrożeniu.
Przestaję rozbudowywać katalog schematów, dopóki istniejące pokrycie nie przekroczy 80%, traktując ten próg jako wewnętrzny cel operacyjny, a nie wymóg Google. Obecność to tylko odhaczenie pozycji. Pokrycie informuje, czy system działa na stronach, które mają znaczenie.
Testowanie, debugowanie i monitorowanie danych strukturalnych
Strona produktu nie przeszła kiedyś testu wyników z elementami rozszerzonymi z powodu błędu typu price invalid błąd. Strona wyglądała poprawnie dla odwiedzającego, ponieważ widoczny komponent ceny promocyjnej radził sobie bezproblemowo z pustą wartością z systemu CMS. Gałąź JSON-LD już nie. Zserializowała puste pole promocji jako cenę oferty.
Odtworzyłem adres URL w dokumencie i procesie roboczym Testu wyników z elementami rozszerzonymi Google, a następnie sprawdziłem sparsowane dane JSON-LD zamiast samego kodu źródłowego strony. Test obsługuje JSON-LD, RDFa i Microdata, a także pokazuje, jakie typy wyników Google strona może wygenerować.
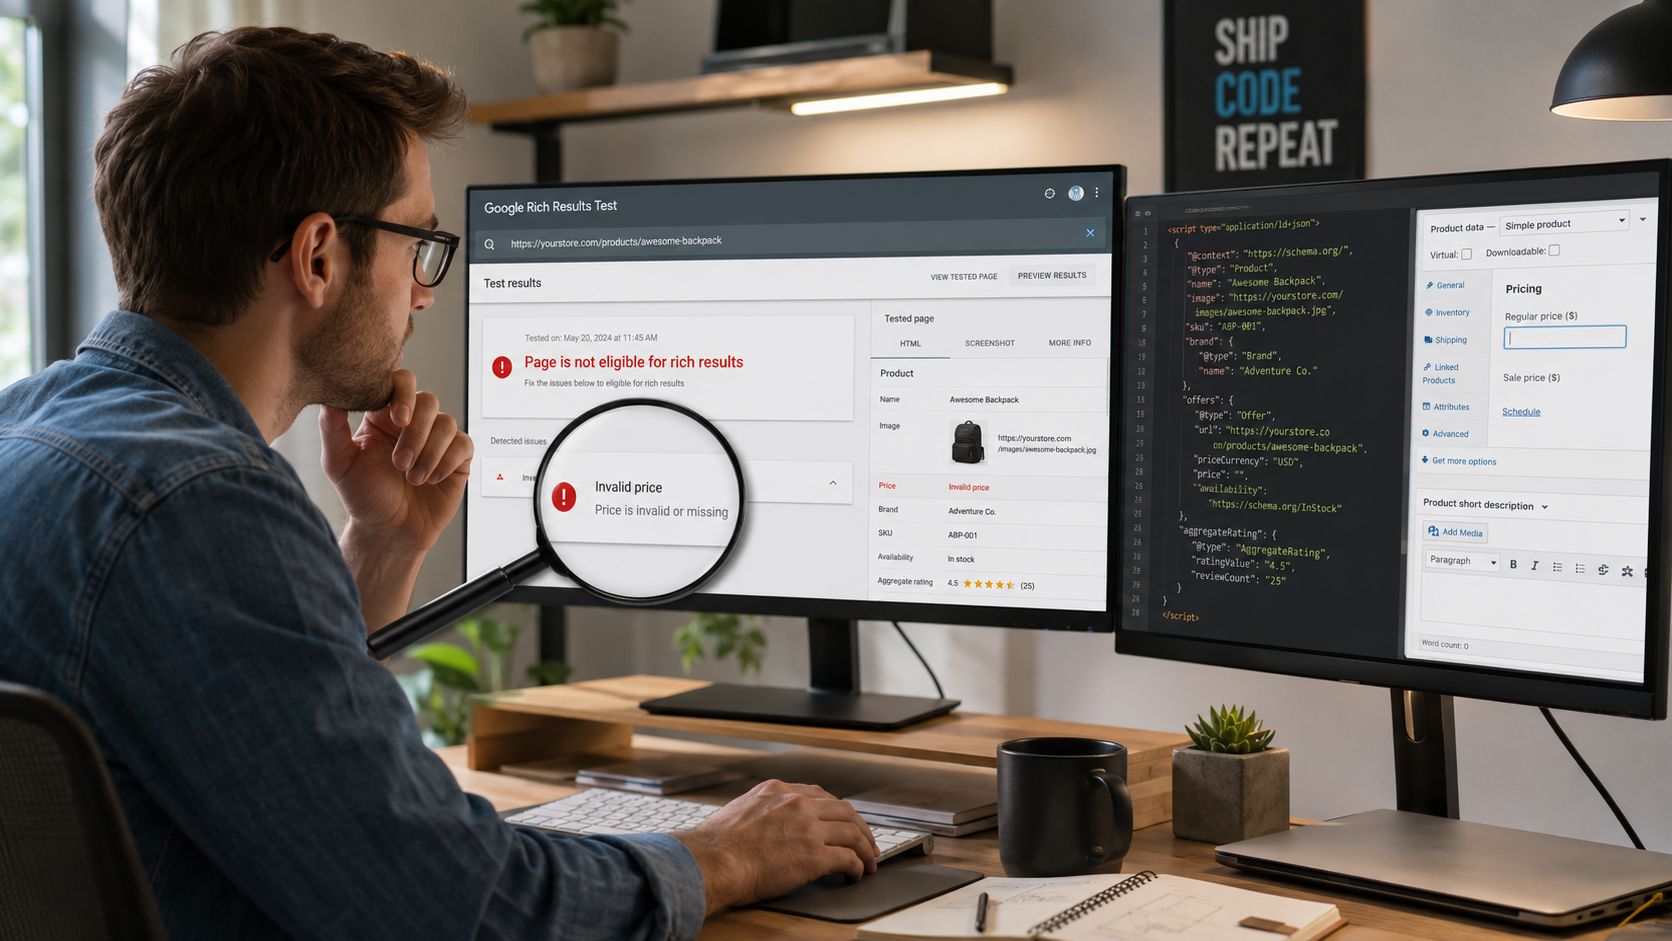
Ścieżka debugowania
Pusta wartość została powiązana z warunkową gałęzią szablonu, która aktywowała się tylko dla produktów objętych promocją. Naprawą nie było usunięcie price właściwości. Poprawiliśmy mechanizm zastępczy, dzięki czemu oferta strukturalna odziedziczyła cenę katalogową, gdy pole ceny promocyjnej było puste, jednocześnie zachowując logikę cenową widoczną na stronie.
Po ponownym wdrożeniu ponownie zweryfikowałem sparsowany obiekt. Sprawdziłem również walidator schematu znaczników (Schema Markup Validator), ponieważ kwalifikowalność Google i poprawność Schema.org odpowiadają na powiązane, ale różne pytania. Jedno potwierdza, czego Google może użyć do obsługiwanych wyników rozszerzonych. Drugie pomaga szerzej zidentyfikować problemy ze słownictwem i strukturą.
Dobra sekwencja debugowania to:
- Odtwórz błąd. Przetestuj na żywo URL i wersję stagingową.
- Sprawdź sparsowane dane wyjściowe. Szukaj pustych ciągów znaków, błędnych typów danych i nieoczekiwanego zagnieżdżenia.
- Prześledź pole źródłowe. Śledź wartość przez logikę systemu CMS i gałęzie warunkowe.
- Popraw szablon. Napraw ścieżkę danych, a nie tylko dotknięty problemem adres URL.
- Wdróż ponownie i przetestuj jeszcze raz. Upewnij się, że błąd znika wsparsowanym wyniku.
- Sprawdź Search Console. Przejrzyj raporty ulepszeń pod kątem powtarzających się wzorców.
Poniższy film jest przydatny, gdy wizualny pokaz pomaga wyjaśnić interfejs testowy.
Monitorowanie pozwala wykryć ciche zmiany
Używam trzech warstw monitorowania. Kluczowe szablony komercyjne są sprawdzane niemal w czasie rzeczywistym podczas wydań. Cotygodniowa partia weryfikuje reprezentatywne adresy URL i obserwuje zmiany w liczbie prawidłowych oraz nieprawidłowych elementów. Miesięczne przeczesywanie mierzy pokrycie w całej bazie adresów URL.
Przepływ raportowania Konsoli Wyszukiwania pozwala właścicielom witryn śledzić, jak zmieniają się prawidłowe i nieprawidłowe elementy danych strukturalnych w czasie. Nie traktuję każdego ostrzeżenia jako sytuacji kryzysowej, ale badam nagłe zmiany, zwłaszcza po wydaniu aktualizacji CMS, cennika, nawigacji lub profilu autora.
Wykorzystanie narzędzi do badań SEO do ustalania priorytetów prac nad schematem
Schemat nie powinien znajdować się w osobnym technicznym backlogu. Ustalając priorytety, traktuję go równolegle z badaniami słów kluczowych, SERP, linków wewnętrznych i zwrotnych, ponieważ te zbiory danych wskazują, gdzie dane strukturalne mają realną szansę na poprawę doświadczenia wyszukiwania.
Zaczynam od stron zajmujących środek pierwszej strony i szczyt drugiej strony dla zapytań komercyjnych lub transakcyjnych. Następnie porównuję ich wyświetlenia i zachowanie kliknięć w Konsoli Wyszukiwania. Strona, która już generuje wyświetlenia, ale brakuje jej kwalifikującego się produktu, ścieżki nawigacyjnej, filmu lub lokalnego ulepszenia, jest silniejszym kandydatem niż strona bez znaczącego zapotrzebowania na zapytania.
Niech dowody z SERP wybiorą typ schematu
Śledzenie funkcji SERP pokazuje, czy rodzina zapytania docelowego wyświetla wyniki produktów, linki do witryn, informacje o wydarzeniach, wyniki wideo lub inne ulepszenia. Ta obserwacja określa, jaki znacznik przetestować. Nie dodaję FAQPage, ponieważ wtyczka ułatwia to zadanie. Dodaję ją tylko wtedy, gdy strona zawiera przydatne, widoczne zasoby pytań i odpowiedzi, a znacznik służy czytelności maszynowej.
Raporty dotyczące linków zwrotnych i wewnętrznych dodają kolejny filtr. Adres URL przepisu lub produktu ukryty poza użyteczną strukturą nawigacji witryny może pozostać trudny do odkrycia, nawet jeśli jego schemat jest doskonały. Naprawienie stron osieroconych i słabych ścieżek wewnętrznych może być warunkiem wstępnym pracy nad schematem.
Przepływ pracy jest prosty:
- Znajdź zapytania z odpowiednią możliwością uzyskania bogatego wyniku.
- Przypisz każde zapytanie do adresu URL z rankingu.
- Potwierdź kwalifikowalność adresu URL i lukę w schemacie.
- Zweryfikuj widoczną zawartość strony i pola danych.
- Dodaj implementację do kolejki według oczekiwanej wartości biznesowej.
Dla szerszego procesu obejmującego luki w słowach kluczowych, analizę SERP i odkrywanie linków zwrotnych, użyłbym tego przewodnika do Narzędzia do badań SEO. Kluczem jest, aby schemat był wynikiem badań. Zapobiega to zespołom spędzaniu tygodni na dopracowywaniu znaczników na adresach URL, które nie mają możliwości wyszukiwania ani nierozwiązanych barier technicznych.
Twoja lista kontrolna danych strukturalnych i co dalej
Gdybym miał tydzień na uczynienie schematu użytecznym, nie zacząłbym od dodawania nowych typów. Pierwsze trzy dni poświęciłbym na audyt pokrycia adresów URL artykułów, produktów i firm lokalnych, a następnie próbowałbym 10% tych adresów URL za pomocą testu Rich Results. Ta liczba próbek jest wewnętrznym wyborem operacyjnym dla praktycznego audytu, a nie wymogiem Google.
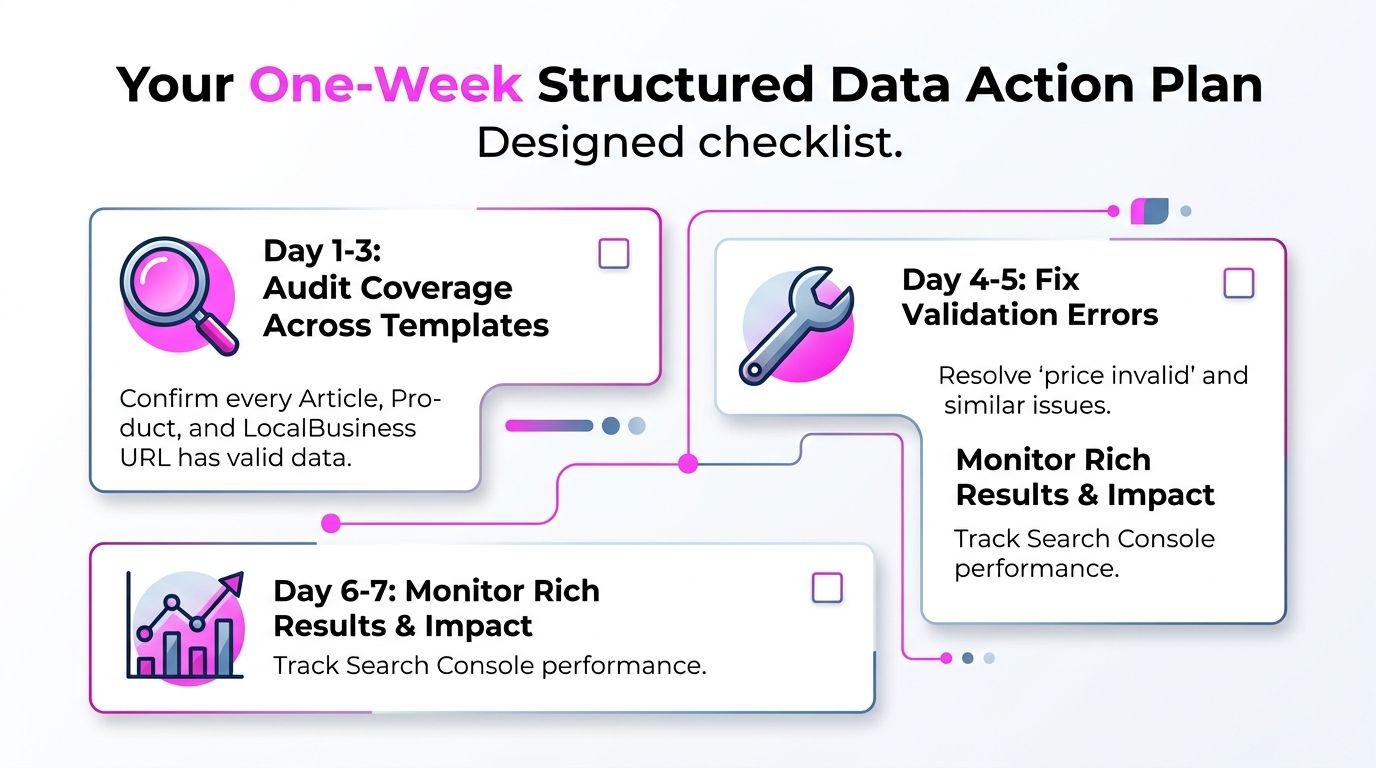
Mój pierwszy tydzień
Dni 1-3 przejdź do inwentaryzacji adresów URL, klasyfikacji szablonów i walidacji. Potwierdzam, że każdy priorytetowy adres URL emituje zamierzony JSON-LD, a jego właściwości pasują do widocznej treści. Oddzielnie rejestruję również zablokowane, noindexed, niedostępne i niekompletne strony, ponieważ każda z nich wymaga innego rozwiązania.
Dni 4 i 5 przejdź do najczęstszych kategorii błędów. Brakujące obrazy, autorzy i ceny zazwyczaj wskazują na problemy z polem źródłowym lub szablonem warunkowym. Naprawiam je na poziomie danych, a następnie ponownie uruchamiam walidację dla stron z każdego dotkniętego szablonu.
Dni 6 i 7 przejdź do pomiarów. Przesyłam mapę witryny, sprawdzam priorytetowe adresy URL z perspektywy Google i taguję grupy zapytań, gdzie wynik zrichtext mógłby wiarygodnie wpłynąć na listę. Google Przepływ pracy implementacji zbioru danych zaleca dodanie wymaganych właściwości, walidację za pomocą testu Rich Results, naprawę krytycznych błędów, wdrożenie kilku stron, ich sprawdzenie i aktualizowanie Google za pomocą mapy witryny.
Co bym odłożył
Przełożyłbym długie frazy kluczowe, takie jak Course lub JobPosting, gdy odpowiednie strony mają niewielki popyt wyszukiwania lub niekompletne dane źródłowe. Odłożyłbym również znaczniki, które wymagają przeglądu polityki dla treści za paywallem, ograniczonych logowaniem lub treści rządowych, dopóki dostęp i kwalifikowalność nie będą jasne.
Miesięcznie przeglądałbym raporty ulepszeń Search Console, porównywał zmiany w kliknięciach dla oznaczonych grup zapytań i ponownie audytował po tym, jak Google wycofa lub ograniczy typ wyniku rozszerzonego. FAQPage jest dobrym przykładem, dlaczego to ważne. Znaczniki, które kiedyś miały widoczną korzyść wyszukiwania, mogą później służyć głównie jako warstwa relacji czytelna dla maszyn.
Trwałym zasobem jest żywy spis schematów. Szablony się zmieniają, pola CMS są przemianowywane, ceny wygasają, autorzy się przenoszą, a funkcje wyszukiwania znikają. Traktuj dane strukturalne jak analitykę. Skonfiguruj je ostrożnie, waliduj je stale i przydziel komuś odpowiedzialność za kontrole.
Użyj SemDash (SemDash) aby połączyć badania słów kluczowych, SERP, konkurencji i linków zwrotnych z lukami w schemacie na poziomie adresu URL, na które należy zwrócić uwagę w pierwszej kolejności. Zacznij od zidentyfikowania stron z rzeczywistą szansą na wyszukiwanie, a następnie wykorzystaj narzędzia platformy do badań i śledzenia, aby nadać priorytet wdrożeniom, które możesz zweryfikować i zmierzyć.