A tag meta robots to dyrektywa HTML na poziomie strony, która kontroluje, jak roboty przeszukujące obsługują zachowanie podczas przeszukiwania, indeksowania i fragmentów, a domyślnie jest to index, follow. Widziałem jeden zbłąkany noindex wiersz, który zrujnował ruch z dnia na dzień, zazwyczaj na stronie, która według kogoś była „bezpieczna”, ponieważ istniała tylko w <head>.
To jest część, którą ludzie pomijają, gdy traktują dyrektywy robots jak odhaczenie pola. W praktyce tag jest powierzchnią do debugowania, a kiedy śledzę nagły spadek, zaczynam od sprawdzenia wyrenderowanego źródła, zanim obwinę treść, linki czy „algorytm”. Jeśli jesteś w tej samej sytuacji, dowiedz się, dlaczego Twój ruch spadł jest przydatnym towarzyszem podczas analizy samego adresu URL, a ja zazwyczaj łączę to z szybkim spojrzeniem na historię na poziomie adresu URL w Narzędzia SemDash do szacowania ruchu.
Spis treści
- Kiedy tag Meta Robots po cichu zabija Twój ruch
- Cztery rodziny dyrektyw i co każda z nich robi
- Tag Meta Robots vs Nagłówek X-Robots-Tag
- Trzy prawdziwe szablony, których używam na stronach produkcyjnych
- Pięć dyrektyw, które widzę źle używane co tydzień
- Lista kontrolna audytu meta robotów, którą przeprowadzam co kwartał
- Naprawianie problemów i weryfikacja wyników
Kiedy tag Meta Robots po cichu zabija Twój ruch
Otrzymałem to samo zgłoszenie niezliczoną ilość razy. Strona, która kiedyś dobrze się plasowała, znika, klient przysięga, że nic się nie zmieniło, a następnie eksport skanowania pokazuje jedną linię w nagłówku, <meta name="robots" content="noindex">. Ta jedna linia wystarczy, aby usunąć adres URL z wyników wyszukiwania, ponieważ domyślne ustawienie Google to nadal index, follow, więc tag ma znaczenie tylko wtedy, gdy chcesz innego zachowania. Własna dokumentacja Google stale podkreśla ramy na poziomie strony, w tym nowszy nacisk na kontrolę na poziomie strony w odświeżeniu robotów z 2025 r., dlatego tag nadal ma znaczenie w nowoczesnym zarządzaniu SEO. Dokumentacja Google dotycząca meta robotów
Dlaczego traktuję to jak dźwignię do debugowania
Błędem nie jest używanie tagu. Błędem jest traktowanie go jak ustawienia szablonu, o którym można zapomnieć. Gdy zespół doda noindex, nofollow, lub ograniczenia fragmentów, dyrektywa ta może zmienić, czy adres URL pojawia się w wynikach wyszukiwania, czy linki na tej stronie są śledzone, a także czy fragmenty lub zapisane w pamięci podręcznej treści w ogóle się pojawiają. Dlatego uważam tag za powierzchnię kontrolną dla architektury, a nie za kosmetyczną poprawkę SEO.
Praktyczna zasada: jeśli adres URL stracił widoczność, a treść nie uległa istotnej zmianie, najpierw sprawdź nagłówek. Znalazłem błędnie zastosowane dyrektywy robots na szablonach stagingowych, zduplikowane szablony stron, a nawet strony szczegółów produktów, które przez przypadek odziedziczyły regułę bloga.
Cztery rodziny dyrektyw mają znaczenie, ponieważ różnie zawodzą. Dyrektywy indeksowania decydują, czy strona w ogóle może się pojawić. Dyrektywy dotyczące indeksowania i linków kształtują, co jest śledzone. Dyrektywy dotyczące fragmentów zmieniają to, co Google jest skłonne pokazać w SERP. A kontrole na poziomie tekstu takie jak data-nosnippet pozwalają ukryć części strony bez obejmowania całego adresu URL.
Dlatego przepływ pracy debugowania jest lepszy niż zapamiętana lista kontrolna. Chcę wiedzieć, co widział robot indeksujący, co pokazały wyniki wyszukiwania i który szablon wygenerował tag. Kiedy te trzy elementy się nie zgadzają, tag robots jest zazwyczaj najszybszym sposobem na wyjaśnienie luki.
Cztery rodziny dyrektyw i co każda z nich robi
Kontrola indeksowania
To są dyrektywy, które sprawdzam najpierw, gdy strona znika z indeksu. index pozwala na włączenie, noindex wyklucza stronę, a none jest skrótem od noindex, nofollow. Google twierdzi również, że domyślnie jest już index, follow, więc jawne index, follow jest zazwyczaj zbędne, chyba że dokumentujesz zamiar w szablonie.
Czysty przykład wygląda tak:
<meta name="robots" content="noindex,follow">
To mówi robotom indeksującym, aby nie indeksowały strony, ale nadal pozwalały im podążać za linkami na niej. Używam tego na stronach, które chcę, aby były odkrywane, ale nie rankingowane, takich jak cienkie strony narzędziowe lub niektóre filtry. Błąd jest oczywisty po fakcie, ale nie w momencie wdrożenia. Ktoś myśli none oznacza „brak specjalnej obsługi”, a strona znika.
Kontrola indeksowania i linków
follow i nofollow kontrolować, czy robot powinien przechodzić przez linki na stronie. Na stronie, która powinna pozostać poza indeksem, ale nadal wspierać odkrywanie, zazwyczaj wolę noindex, follow niż ogólne none ponieważ to drugie również blokuje śledzenie linków.
<meta name="robots" content="noindex,nofollow">
Ta wersja usuwa stronę i blokuje śledzenie linków. Jest przydatna, gdy sama strona jest zbędnym balastem, ale może być zbyt agresywna, jeśli strona nadal zawiera cenne wewnętrzne ścieżki. Widziałem zespoły, które łamały ścieżki indeksowania, używając nofollow na stronach znajdujących się w pobliżu ważnych centrów kategorii.
Kontrolki fragmentów i źródeł
Google obsługuje oddzielny zestaw dyrektyw dotyczących fragmentów, w tym nosnippet, max-snippet, max-image-preview, max-video-preview, a unavailable_after. nosnippet jest tępy instrument. max-snippet:50 jest czapką. max-image-preview:large i jego rodzeństwo kontrolują obsługę podglądu. unavailable_after jest sygnałem czasowego usunięcia.
data-nosnippet działa inaczej, ponieważ jest stosowany do elementów strony, a nie do całego adresu URL. Jest to przydatne, gdy tylko część strony powinna pozostać poza fragmentami. Używałem go na stronach, gdzie jeden akapit był wrażliwy, ale reszta treści musiała pozostać w pełni indeksowalna.
Praktyczna zasada: użyj najwęższego dyrektywy, która rozwiązuje rzeczywisty problem. Jeśli musisz ukryć tylko fragment, nie indeksuj całego adresu URL.
| Rodzina dyrektyw | Przykładowe wartości | Co to kontroluje |
|---|---|---|
| Indeksowanie | index, noindex, none |
Czy adres URL może pojawić się w wynikach wyszukiwania |
| Pobieranie i linki | follow, nofollow |
Czy linki na stronie są śledzone |
| Snippet | nosnippet, max-snippet:50, max-image-preview:large, unavailable_after |
Co pojawia się w SERP-ach i na jak długo |
| Kontrola źródła na poziomie tekstu | data-nosnippet |
Konkretne elementy strony, które nie mogą być użyte w snippetach |
Tag Meta Robots vs Nagłówek X-Robots-Tag
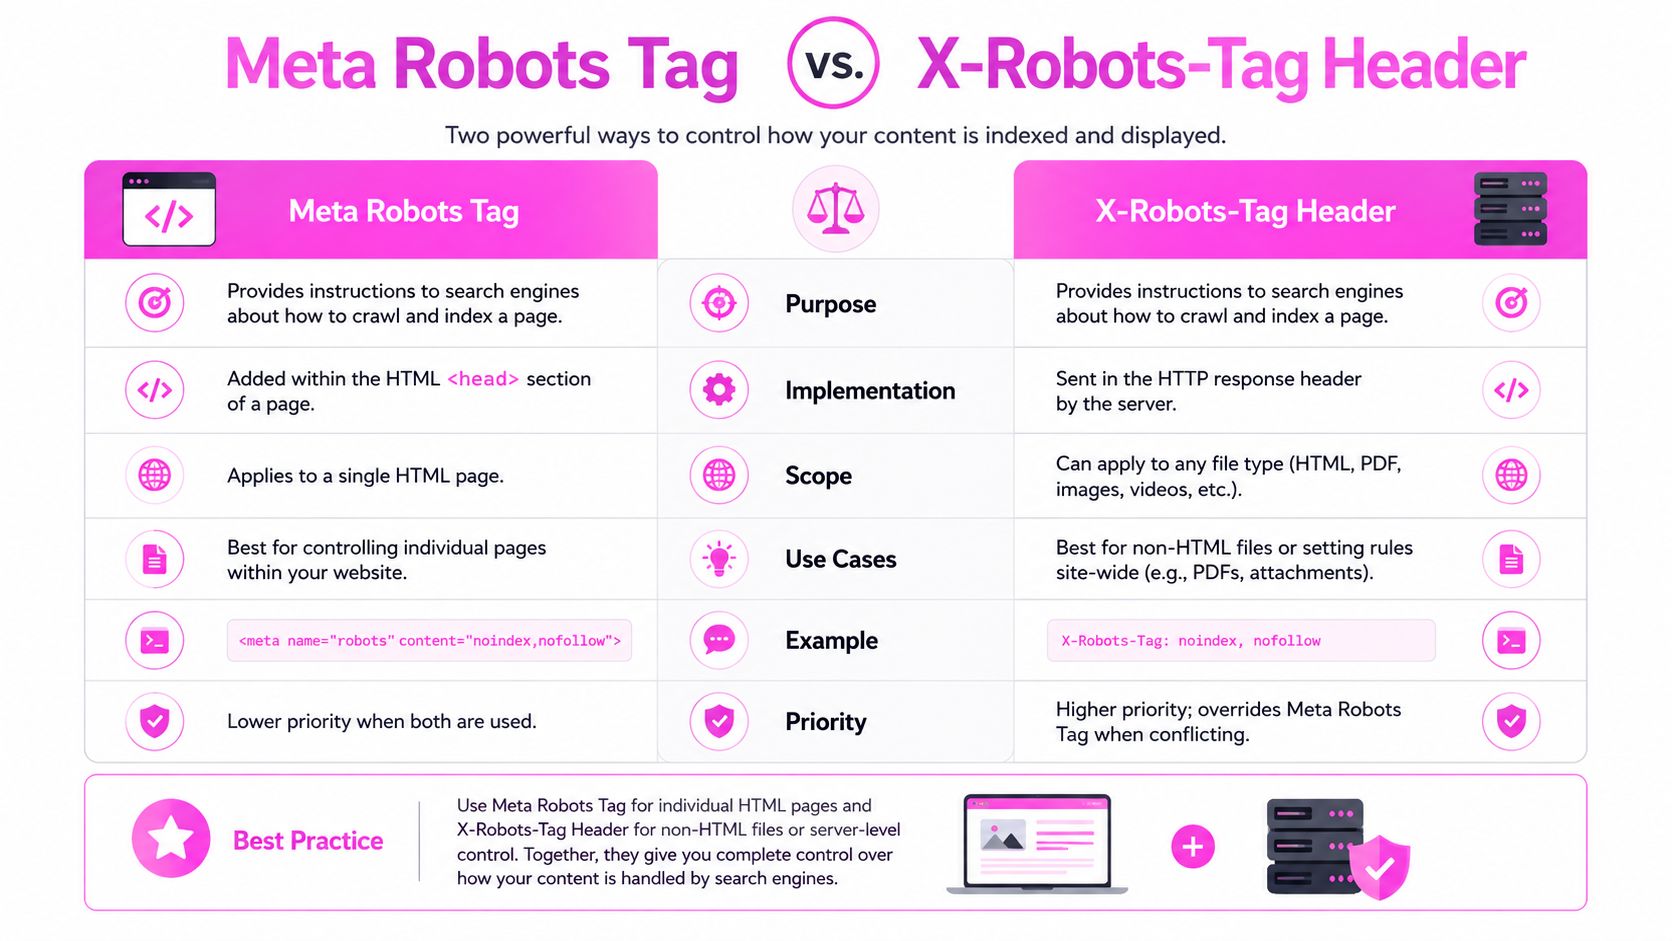
Tag meta na samej stronie to najszybszy sposób na kontrolowanie zwykłych adresów URL w formacie HTML. X-Robots-Tag nagłówek rozwiązuje przypadki, w których nie ma nagłówka HTML do edycji, więc pasuje do plików PDF, obrazów i innych zasobów, które znajdują się poza dokumentem. Dokumentacja Google wyraźnie rozdziela te zastosowania, a także pokazuje, że dyrektywy na poziomie strony mogą być przesyłane w nagłówku HTTP, podczas gdy kontrolki na poziomie tekstu pozostają w elemencie strony. Specjalna dokumentacja tagów Google
Gdzie co należy
Traktuję tag jako decyzję dotyczącą szablonu, a nagłówek jako decyzję dotyczącą warstwy dostarczania. W Shopify, WordPress lub dowolnej aplikacji renderowanej po stronie serwera, tag meta jest zazwyczaj najczystszą ścieżką dla HTML. W przypadku pliku PDF nie marnuję czasu na próby wstawienia nagłówka do pliku. Ustawiam nagłówek i idę dalej.
Ten podział ma jeszcze większe znaczenie, gdy obie dyrektywy dotyczą tego samego adresu URL. Google stosuje surowszą zasadę, więc strona z jedną instrukcją mówiącą index i drugą mówiącą noindex będzie przestrzegać bardziej restrykcyjnej wersji. Mieszane wdrożenie to źródło wielu błędów indeksowania, ponieważ strona wygląda dobrze w systemie CMS, podczas gdy robot sieciowy odczytuje inną dyrektywę z serwera lub sieci CDN.
Od czego zaczynam audyt
Najpierw sprawdzam trzy rzeczy.
- Miejsce dostarczenia, czyli czy dyrektywa znajduje się w kodzie HTML, czy w nagłówku.
- Typ zasobu, czyli czy adres URL to zwykła strona, czy plik niebędący plikiem HTML.
- Ryzyko konfliktu, czyli czy szablon CMS, reguła CDN lub konfiguracja serwera wysyłają już coś bardziej restrykcyjnego.
Największym błędem operacyjnym jest zakładanie, że znacznik meta i nagłówek są zamienne. Rozwiązują one inne problemy wdrożeniowe, a gdy oba są obecne na tym samym adresie URL, robot nie negocjuje. Wybiera surowszą ścieżkę.
Przy większych audytach mapuję te dyrektywy na dane crawlowania na poziomie adresów URL, a następnie porównuję bieżący wynik z historycznym zachowaniem SERP za pomocą SemDash oraz narzędzi takich jak Przewodnik po crawlerze SEO Wispra. Zazwyczaj to tam pojawia się cicha utrata ruchu – sparametryzowany adres URL znika, plik PDF znika z indeksu lub zmiana szablonu wysyła noindex do stron, które miały pozostać widoczne.
Trzy prawdziwe szablony, których używam na stronach produkcyjnych
Wdrażałem te same trzy wzorce wielokrotnie, ponieważ rozwiązują realne problemy z indeksowaniem bez przesadzania. Na pierwszy rzut oka są proste, ale różnica między bezpiecznym szablonem a uszkodzonym tkwi zazwyczaj w jednym atrybucie.
Nawigacja fasetowa, która powinna pozostać dostępna dla crawlerów
W przypadku filtrów i adresów URL z fasetami zazwyczaj zaczynam od:
<meta name="robots" content="noindex,follow">
Dzięki temu strona nie trafi do indeksu, a wewnętrzne linki pozostaną wykrywalne. Jest to dobre rozwiązanie, gdy strona jest przydatna jako ścieżka indeksowania, ale nie jako cel rankingowy. Sygnał audytu to zazwyczaj nieuporządkowany klaster adresów URL w historii SERP, gdzie ten sam zamiar zaczyna przeskakiwać między adresami URL z parametrami, a jeden z nich nagle znika po zmianie szablonu.
Cienkie strony tagów generowane przez platformę blogową
Gdy system blogowania tworzy dziesiątki stron tagów o niskiej wartości, często używam:
<meta name="robots" content="noindex,follow">
Powód jest prosty. Chcę, aby wyszukiwarki nadal docierały do grafu artykułów, ale nie chcę, aby cienkie archiwa konkurowały z faktyczną treścią. Zazwyczaj pojawia się to po przeglądzie mapowania na poziomie adresów URL, który pokazuje, że archiwum tagów jest indeksowane, podczas gdy pod artykułem wykonuje pracę.
Treści chronione hasłem lub wymagające logowania
W przypadku treści chronionych hasłem często łączę kontrolę usuwania z tłumieniem fragmentów:
<meta name="robots" content="noindex,nosnippet">
Dzięki temu mam stronę, która nie pojawia się w indeksie i nie ujawnia podglądu. Jest to przydatne, gdy treść ma wspierać obecnych użytkowników, a nie przyciągać publicznego ruchu z wyszukiwarek. Wyzwalaczem jest zazwyczaj anomalia w historii SERP, gdzie strona plasuje się na branded terms, mimo że wyraźnie nie jest przeznaczona do publicznego dostępu.
Jeśli chcesz uzyskać szerszy obraz zachowania robotów na różnych szablonach, Przewodnik po crawlerze SEO Wispra jest przydatnym odniesieniem, zwłaszcza gdy sprawdzasz, czy problem leży w renderowaniu, odkrywaniu, czy obsłudze dyrektyw.
Odkryłem, że notatki w CMS są równie ważne jak sam tag. Jeśli zmienna szablonu jest ukryta w ustawieniach motywu lub konfiguracji trasy, następna runda czyszczenia może cofnąć Twoją poprawkę, a nikt się nie zorientuje.
Przejścia wideo pomagają, gdy śledzisz te same błędy w wielu szablonach.
Pięć dyrektyw, które widzę źle używane co tydzień
Najczęstsze błędy robotów nie są dramatyczne. To drobne niedopasowania między intencją a składnią, które objawiają się jako ciche dziwactwa indeksowania, wyglądające jak problem z rankingiem, dopóki nie sprawdzisz źródła.
Domyślne ustawienie jest nadpisywane bez powodu
Nadal widzę szablony, które jawnie dodają index, follow wszędzie. To nie szkodzi, ale zaśmieca nagłówek i utrudnia audyty. Ponieważ domyślne ustawienie Google to już index, follow, te linie rzadko coś rozwiązują.
Lepszą wersją często jest brak tagu meta robots. Jeśli strona ma być indeksowalna, cisza jest czystsza niż ceremonia.
Skrót, który ludzie błędnie odczytują
none najczęściej sprawia zespołom kłopoty. To nie znaczy „brak specjalnego traktowania”. To znaczy noindex, nofollow. Obserwowałem, jak cały archiwum zniknął, ponieważ ktoś założył, że none był neutralnym symbolem zastępczym.
Konflikt, który wygrywa w zły sposób
Ogólny robots tag i specyficzny dla robota googlebot tagi mogą się nakładać, a Google zastosuje bardziej restrykcyjny wynik. To potężne, gdy chcesz wyjątku tylko dla Google, ale niebezpieczne, gdy zespół zapomina, że ogólna zasada nadal obowiązuje.
Złamany wzorzec wygląda tak:
<meta name="robots" content="index">
<meta name="googlebot" content="noindex">
Google odczytuje to jako noindex. Jeśli właściciel witryny oczekiwał, że wygra ogólna zasada, niespodzianką jest zazwyczaj spadek ruchu i wiele zamieszania.
Kontrola fragmentu, która nie ukrywa strony
max-snippet:0 jest często używana jako przełącznik ukrywania. Tak nie jest. Jeśli celem jest całkowite usunięcie podglądu strony, nosnippet jest bezpośrednią dyrektywą. Widziałem zespoły używające max-snippet:0 a potem zastanawiające się, dlaczego wynik nadal zachowywał się inaczej niż w pełni wyciszony fragment.
Strona z podziałem na strony, która jest nadmiernie zoptymalizowana
Noindexing adresów URL z podziałem na strony jest częstą nadmierną reakcją. Może to usunąć przydatne ścieżki odkrywania i utrudnić dostęp do całej serii poprzez przepływ indeksowania. Widziałem, jak łamało to odkrywanie w dużych systemach archiwów, gdzie warstwa z podziałem na strony była jedyną niezawodną ścieżką do głębszych treści.
Zasada, której używam: jeśli dyrektywa ma na celu ograniczenie widoczności, upewnij się, że faktycznie ogranicza warstwę, na której Ci zależy. Kontrola fragmentów nie jest kontrolą indeksowania, a kontrola indeksowania nie jest projektowaniem ścieżki indeksowania.
Lista kontrolna audytu meta robotów, którą przeprowadzam co kwartał
Pierwsze przejście jest zawsze mechaniczne. Eksportuję każdy adres URL, który można zaindeksować, a następnie filtruję strony, które zawierają tag meta robots, ponieważ domyślnym stanem jest zazwyczaj brak tagu. Stamtąd porównuję listę dyrektyw z tym, co historia SERP i mapowanie na poziomie adresu URL mówią o tym, co strona robiła w czasie, ponieważ tam najpierw pojawiają się ciche błędy. To API Markdown staje się przydatne dla zespołów potrzebujących czystej ekstrakcji HTML do tekstu podczas masowych audytów, zwłaszcza gdy strony źródłowe są niechlujne lub mocno szablonowe.
Co sprawdzam w kolejności
- Najpierw eksport indeksowania. Oznaczam każdy adres URL z jakąkolwiek dyrektywą robotów i oddzielam tagi HTML od nagłówków.
- Następnie historia SERP. Porównuję intencje dyrektyw z sygnałami widoczności z ostatnich 12 miesięcy, aby znaleźć strony, które nie odpowiadają ich obecnemu stanowi.
- Skanowanie kolizji. Sprawdzam konflikty tagów meta i nagłówków X-Robots-Tag na tym samym adresie URL.
- Nadpisania specyficzne dla robota. Weryfikuję, czy
googlebotreguły nie nadpisują ogólnejrobotsreguły. - Sprawdzenie krzyżowe sygnałów. Analizuję ruch organiczny, domeny odsyłające i cytaty z Przeglądu AI, aby wykryć strony, które są nadmiernie ograniczone.
Co zazwyczaj oznacza niedopasowanie
Jeśli strona jest oznaczona jako noindex ale nadal się pozycjonuje, zazwyczaj znajduję przestarzałą pamięć podręczną, problem z renderowaniem lub konflikt nagłówków i metadanych. Jeśli strona nie ma dyrektywy i nagle zniknęła, najpierw szukam problemu z dziedziczeniem szablonu. Kiedy strona jest ważna, a mapowanie zmieniło się bez publikacji treści, jest to silny sygnał, że reguła robotów została dodana gdzieś niewidocznym dla zespołu ds. treści.
Pilnuję też grup stron, które powinny pozostać otwarte dla odkrywania, ale zostały ograniczone podczas sprintu porządkowego. To właśnie one tracą zasięg wewnętrzny, podczas gdy wszyscy świętują „bardziej kontrolowany” szablon.
Przepływ pracy optymalizacji treści w SemDash jest przydatny, gdy muszę połączyć wyniki analizy robotów z ogólną wydajnością strony, ponieważ błąd dyrektywy rzadko pozostaje ograniczony do jednego adresu URL.
Naprawianie problemów i weryfikacja wyników
Najpierw naprawiam adresy URL z prawdziwym potencjałem, te, które już zdobyły linki lub miały duże zapotrzebowanie w wyszukiwarkach, zanim dyrektywa została zmieniona. Następnie wdrażam poprawkę w warstwie szablonu lub nagłówka, a nie przez edycję poszczególnych stron jedna po drugiej, ponieważ jednorazowe poprawki giną przy następnej aktualizacji CMS. Najczystsze wdrożenia to te, w których powód dyrektywy jest udokumentowany tuż obok reguły.
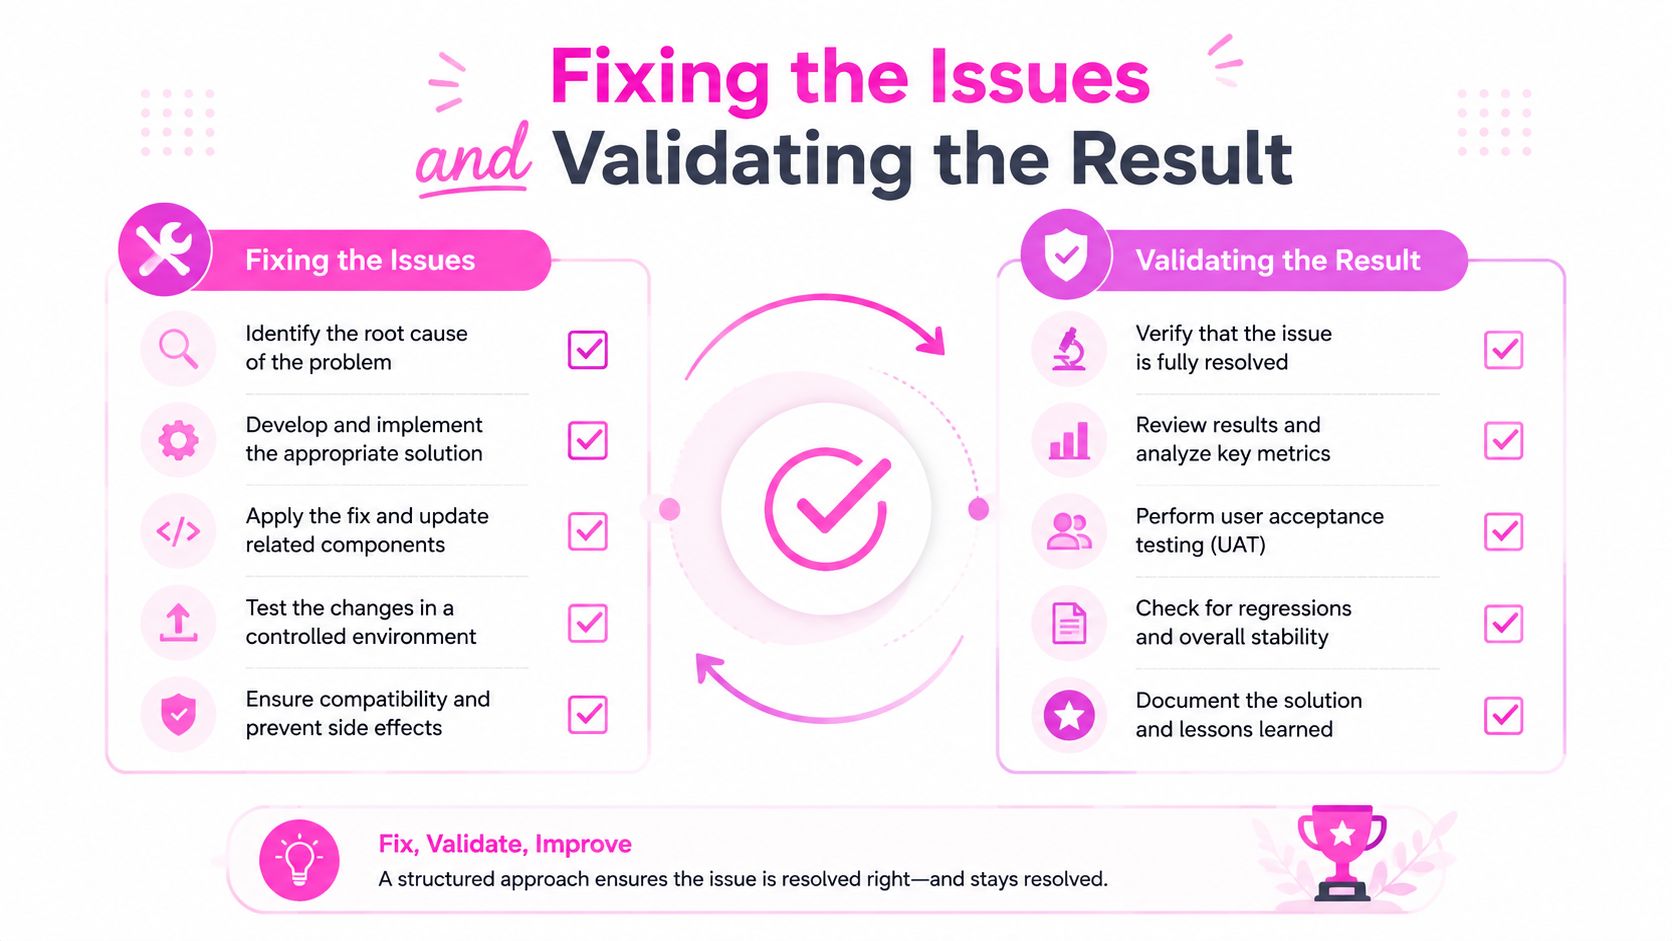
Jak weryfikuję poprawkę
Obserwuję adres URL w historii SERP i widokach mapowania, a następnie potwierdzam, że renderowane źródło lub nagłówki odpowiedzi uległy zmianie. Jeśli strona była wcześniej ukryta, oczekuję, że stan indeksowania zmieni się dopiero po ponownym przetworzeniu adresu URL przez indeksator. Dlatego nie ufam samemu zapisaniu szablonu.
Pętla walidacji jest prosta:
- Potwierdź, że dyrektywa zniknęła lub została poprawiona w źródle lub nagłówkach.
- Ponownie zaindeksuj adres URL i sprawdź, czy stan SERP się zmienił.
- Uważaj na sąsiednie kolizje, ponieważ poprawki szablonów mogą wpływać na powiązane adresy URL, jeśli reguła jest zbyt szeroka.
- Zostaw notatkę w szablonie, aby następny inżynier wiedział, dlaczego dyrektywa istnieje.
Praktyczna zasada: jeśli strona nie potrzebuje tagu meta robots, pomiń go. Jeśli go potrzebuje, udokumentuj powód tam, gdzie znajduje się szablon.
Chodzi o to, aby powstrzymać niewidoczne szkody SEO, zanim się skumulują. Taka jest wartość ścisłego przepływu pracy robotów i dlatego wolę walidować za pomocą samej strony, zamiast polegać na założeniach, zrzutach ekranu lub czyjejś pamięci.
Jeśli chcesz mieć czystszy sposób na wyłapywanie błędów dyrektyw robotów, zanim zniszczą ruch, użyj SemDash (SemDash) do mapowania widoczności na poziomie adresu URL, śledzenia historii SERP i wykrywania zmian indeksowania, gdy można je jeszcze naprawić. To najszybszy sposób, jaki znam, aby połączyć anomalię skanowania z dokładną stroną, która ją spowodowała, a następnie udowodnić, że poprawka została wdrożona.