Większość porad dotyczących kanibalizacji słów kluczowych zaczyna się w złym miejscu. Jeśli widzę dwa adresy URL pozycjonujące się dla jednego słowa kluczowego, jeszcze nie nazywam tego problemem, nazywam to wskazówką. Problem zazwyczaj polega na niestabilności własności zapytania, gdzie Google ciągle przełącza się między stronami, powierzchniami lub intencjami, zamiast ustalić jeden wyraźnie preferowany adres URL.
To rozróżnienie ma znaczenie, ponieważ wiele zespołów zbyt wcześnie scala strony i niszczy potrzebne im pokrycie. Zapytanie może wyglądać na zduplikowane w arkuszu kalkulacyjnym i nadal być zdrowe, jeśli jedna strona obsługuje główną intencję, podczas gdy inna zaspokaja węższą potrzebę. Audyt, któremu ufam, zaczyna się od zadania trudniejszego pytania, który adres URL wygrywa to zapytanie w czasie i czy zwycięzca jest stabilny?
Spis treści
- Dlaczego większość diagnoz kanibalizacji jest błędna
- Tworzenie mapy zapytań do stron w Search Console
- Nakładanie wyszukiwań w witrynie, indeksowania i sprawdzania historii rankingów
- Cztery testy, które oddzielają prawdziwą kanibalizację od szumu
- Jak wygląda prawdziwy audyt
- Ocenianie i priorytetyzacja zapytań wartych naprawy
- Lista kontrolna audytu i co następuje po identyfikacji
Dlaczego większość diagnoz kanibalizacji jest błędna
Skrócona diagnoza, „dwa adresy URL pozycjonują się dla jednego słowa kluczowego”, wyłapuje zbyt dużo szumu. Widziałem zespoły, które zapominały o stronach obsługujących różne intencje, a potem miesiącami odbudowywały ruch z długiego ogona, który mogły zachować. Bezpieczniejsza definicja jest węższa: zapytanie jest kanibalizowane, gdy właścicielstwo ciągle się zmienia między stronami w ciągu ostatnich tygodni, CTR odbiega od tego, co sugeruje łączny udział wyświetleń, a żadna pojedyncza strona nie utrzymuje stabilnej pozycji.
Dlatego pojedynczy zrzut ekranu jest słabym dowodem. Search Console może pokazać nakładanie się bez dowodzenia szkody, a szerokie nakładanie się jest czasami normalną wewnętrzną konkurencją, a nie problemem strukturalnym, zwłaszcza gdy jeden adres URL jest wyraźnie dominujący. Praktyczną podstawą, której używam, jest to, czy zapytanie pokazuje konkurujące adresy URL o podobnych tytułach lub nagłówkach H1, nakładające się wyświetlenia i wzorzec przełączania adresów URL, a nie tylko współistniejące wyniki.
Na co zwracam uwagę przed stwierdzeniem kanibalizacji
Czysty audyt rozdziela trzy sytuacje, które często są wrzucane do jednego worka:
- Segmentacja intencji, gdzie dwie strony dotyczą tego samego tematu, ale zaspokajają różne potrzeby.
- Przesunięcie w SERP, gdzie funkcje AI lub inne typy wyników przesuwają adresy URL z wyników organicznych.
- Prawdziwa kanibalizacja, gdzie Google nie może zdecydować się na jedną stronę, ponieważ witryna stale wysyła sprzeczne sygnały.
Takie ujęcie jest zgodne z nowoczesnymi przepływami pracy Search Console, które eksportują zapytania i strony, zliczają unikalne adresy URL na zapytanie i sprawdzają naprzemienne posiadanie adresów URL w czasie, zamiast polegać na jednym widoku danych. Pasuje to również do porady, aby porównywać stabilne pokrycie w ciągu tygodni, a nie pojedynczy migawki rankingów, ponieważ zmienność ujawnia podstawowy problem. Szybkie site:yourdomain.com keyword wyszukiwanie może pomóc, ale jest to tylko krok przesiewowy, a nie dowód, ponieważ pokazuje sygnały trafności i indeksacji, a nie pełne dane o wyświetleniach lub kliknięciach. Jak zauważono we wcześniejszych wskazówkach z Search Engine Journal, najsilniejszą heurystyką jest nadal zapytanie z 2 lub więcej konkurencyjnymi adresami URL, podobnymi tytułami i nakładającymi się wyświetleniami.
Tworzenie mapy zapytań do stron w Search Console
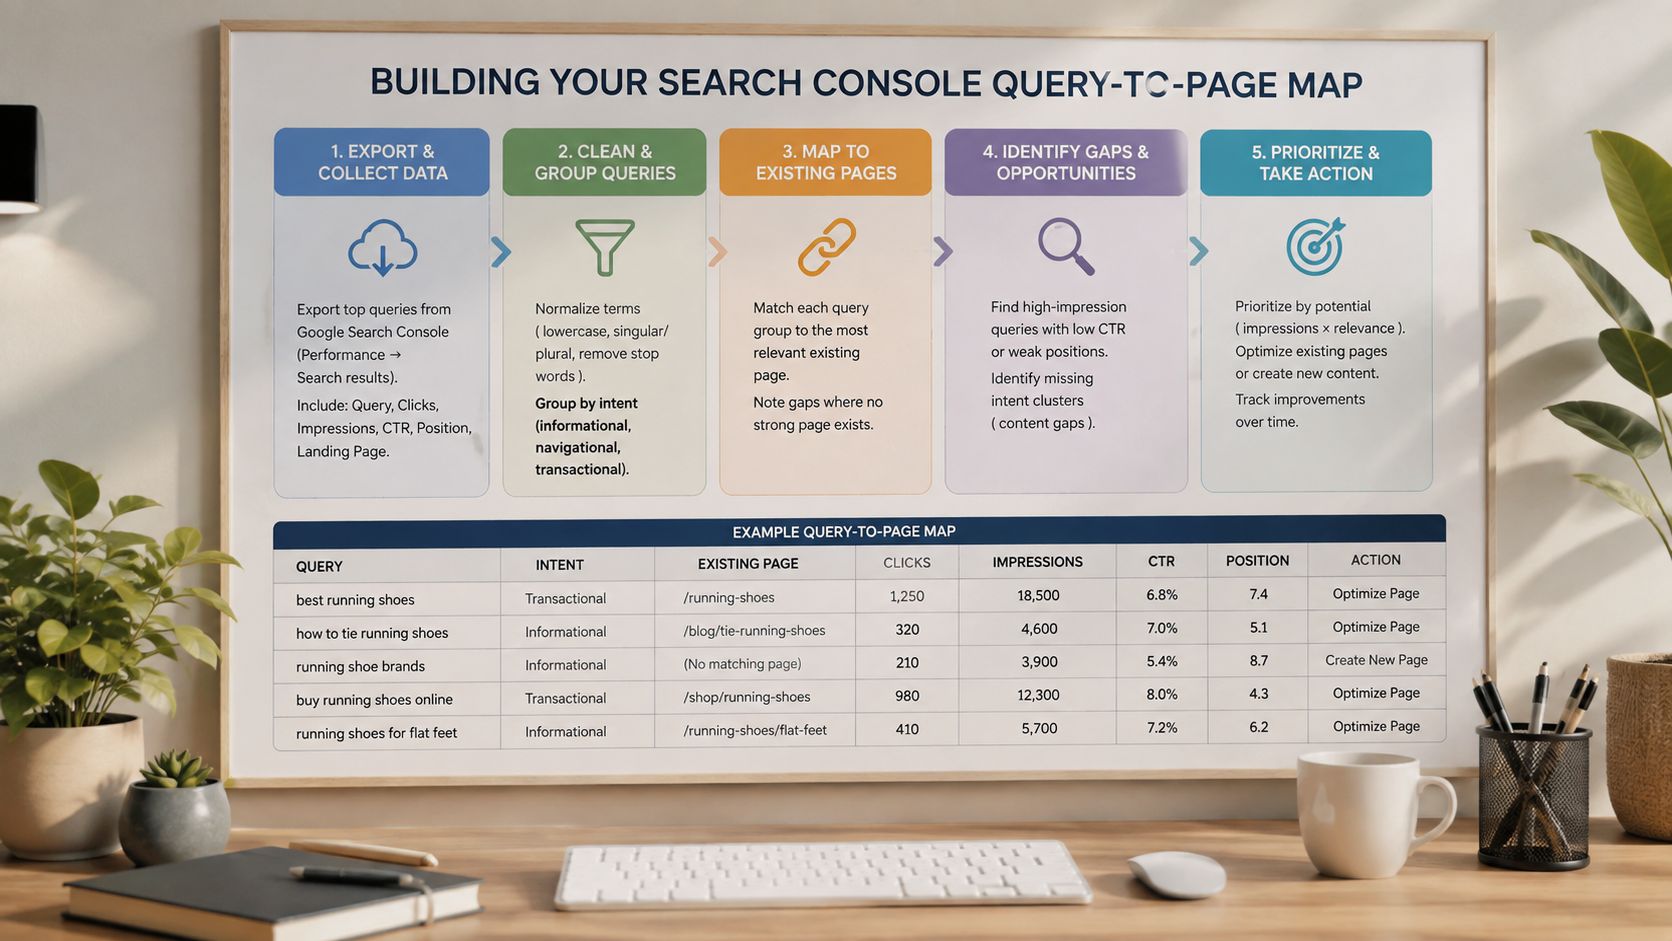
Najczystszym sposobem, jaki znalazłem na zidentyfikowanie kanibalizacji słów kluczowych, jest rozpoczęcie od danych Wydajności Search Console, a nie od eksportu z indeksowania czy narzędzia do śledzenia pozycji. Najpierw pobieram dane z ostatnich 16 tygodni zapytań i stron, ponieważ ten okres jest wystarczająco długi, aby wychwycić zmiany zachowań, nie wciągając przy tym przestarzałych danych, które zaciemniają obraz. Jeśli strona jest duża, ustawiam filtr roboczy na ponad 50 wyświetleń , aby arkusz kalkulacyjny skupiał się na zapytaniach, które mogą generować ruch.
Przepływ pracy mapowania, którego używam
- Eksportuj zapytania i strony osobno. Oryginalne pliki pozostawiam nietknięte i normalizuję adresy URL, zanim cokolwiek zintegruję. Ma to znaczenie, ponieważ grupowanie podfolderów, warianty parametrów i niespójności z ukośnikiem na końcu mogą sprawić, że jedna strona będzie wyglądać jak kilka.
- Zbuduj mapę zapytań do stron. W arkuszu kalkulacyjnym lub Looker Studio wymień każde zapytanie i każdą stronę, która otrzymała dla niego wyświetlenia, a następnie dodaj kliknięcia, CTR i średnią pozycję. Sama średnia pozycja może wprowadzać w błąd, ponieważ strona, która pojawia się w wielu zróżnicowanych wynikach wyszukiwania, może wykazywać przyzwoią średnią, tracąc jednocześnie dominację.
- Zlicz unikalne adresy URL na zapytanie. Oznaczam zapytania z 2 lub więcej adresami URL otrzymującymi wyświetlenia, a następnie ignoruję przypadki, w których dodatkowy adres URL przyczynia się do mniej niż 5% wszystkich kliknięć. Dzięki temu łagodne nakładanie się nie zaśmieca kolejki przeglądu.
- Sortuj według koncentracji udziału kliknięć. Jeśli żaden pojedynczy adres URL nie dominuje w ponad 70% kliknięć, traktuję zapytanie jako poważnego kandydata.
Praktyczna zasada: Jeśli mapa zapytań do stron zmienia się z tygodnia na tydzień, zwracam na to większą uwagę niż na surową liczbę stron.
Zakres dat ma znaczenie, ponieważ zachowanie przełączania jest czasowe. Widziałem zapytania, które wyglądały czysto w 28-dniowym migawce i niechlujnie w eksporcie 16-tygodniowym. Szersze okno pomaga mi również oddzielić nakładające się strony od uzasadnionych różnic formatów, takich jak adresy URL obrazów, filmów lub wyników produktów, które mogą pojawiać się obok standardowych stron.
Dobry arkusz audytu powinien również zawierać proste pole na notatki dla każdego zapytania, abym mógł zarejestrować, czy nakładanie się wygląda jak szum indeksowania, duplikacja treści, czy niestabilność rzeczywistego posiadania. Ten dziennik staje się ścieżką dowodową, gdy nadejdzie czas, aby zdecydować, czy skonsolidować, kanonizować, czy pozostawić strony w spokoju.
Nakładanie wyszukiwań w witrynie, indeksowania i sprawdzania historii rankingów
Lista GSC to tylko pierwszy krok. Waliduję każdego kandydata trzema warstwami, aby nie liczyć tego samego sygnału dwukrotnie w różnych narzędziach. Kolejność ma znaczenie, ponieważ strona może wyglądać na konkurencyjną w Search Console, a następnie okazać się niegroźnym pokryciem, gdy sprawdzę intencję, indeksowanie i historię rankingów razem.
Jak waliduję zapytanie kandydata
Najpierw używam site: operatora dla dokładnego zapytania i sprawdzam, które adresy URL Google już z nim kojarzy. To szybkie wyszukiwanie daje mi wyobrażenie o typie fragmentu, linkach do witryny i o tym, czy Przegląd AI lub inna powierzchnia wyników może wypierać kliknięcia organiczne, zamiast wywoływać klasyczny konflikt strona-vs-strona. To etap przesiewowy, a nie werdykt.
Po drugie, analizuję adresy URL kandydatów. Szukam niewielkiego nakładania się treści, wspólnych elementów szablonów, powtórzeń hreflang oraz wewnętrznego tekstu kotwice (anchor text), który kieruje Google w stronę słabszej strony. Jeśli analiza wykaże te same sygnały intencji na obu adresach URL, traktuję to jako potwierdzenie. Jeśli strony wyraźnie się różnią, oznaczam nakładanie się jako celowe i idę dalej.
Po trzecie, przeglądam historię rankingów w ruchomym oknie czasowym. Używam narzędzi takich jak AccuRanker, Semrush lub codziennych pobrań z Search Console i zauważyłem, że wzorzec zamiany miejsc adresów URL ma znacznie większe znaczenie niż pojedynczy spadek pozycji. Jeśli główny adres URL stale się zmienia dla tego samego zapytania, to silny znak, że witryna nie ustaliła jasnej dominacji.
Dla zespołów, które potrzebują szerszej warstwy monitorowania, poradnik dotyczący monitorowania pozycji wspieranego przez AI jest przydatny, ponieważ przedstawia ruchy w rankingu w kontekście zmian na poziomie adresów URL, a nie tylko pozycji słów kluczowych. To znacznie lepsze rozwiązanie do pracy nad kanibalizacją niż pulpity, które spłaszczają wszystko do pojedynczej średniej pozycji.
| Warstwa | Narzędzie lub źródło | Co to potwierdza | Przekroczenie progu |
|---|---|---|---|
| Widoczność w wyszukiwarce | Google Search Console | Wiele adresów URL generujących wyświetlenia dla tego samego zapytania | 2 lub więcej konkurencyjnymi adresami URL |
| Sprawdzenie indeksu i SERP | site: Przegląd wyszukiwania i SERP na żywo |
Które adresy URL Google już kojarzy z danym terminem, a także kontekst fragmentu i powierzchni AI | Pojawia się więcej niż jeden odpowiedni adres URL |
| Przegląd historii | Narzędzie do śledzenia pozycji lub codzienne pobieranie danych z GSC | Czy własność jest stabilna, czy się zmienia | Powtarzające się przełączanie adresów URL w czasie |
Kandydat przechodzi dalej tylko wtedy, gdy co najmniej dwa z trzech poziomów niezależnie wykażą aktywną konkurencję. Ta zasada chroni mnie przed nadmierną reakcją na normalną zmienność. Daje mi również uzasadnione uzasadnienie w pliku audytu, co jest ważne, gdy klient później pyta, dlaczego jedna strona pozostała nietknięta, a inna została skonsolidowana.
W przypadku diagnozy opartej na indeksowaniu sprawdzam również kontrolę indeksowania. Wewnętrzne wytyczne dotyczące obsługi tagów meta robots są istotne, gdy słabsza strona musi pozostać dostępna dla użytkowników, ale nie konkurować w wyszukiwaniu.
Cztery testy, które oddzielają prawdziwą kanibalizację od szumu
Najszybszym sposobem na uniknięcie złych poprawek jest testowanie nakładania się pod kątem zachowania, a nie tylko słów kluczowych. Używam czterech testów, ponieważ każdy z nich wykrywa inny rodzaj problemu. Strona może przejść jeden test i nadal być słabym kandydatem do połączenia, jeśli inny test wykaże wyraźne rozdzielenie intencji.
Framework czterech testów
Test 1, częstotliwość zmian. Mapuję ruch w rankingach w okresie 90 dni i oznaczam tylko te zapytania, w których dwa adresy URL zamieniają się miejscami w top 10 co najmniej trzy razy. Taki wzorzec trudno zignorować jako zwykły szum w wynikach wyszukiwania.
Test 2, korelacja z funkcjami SERP. Porównuję nakładanie się z aktualnymi wynikami SERP. Jeśli spadek widoczności strony pojawia się dopiero po tym, jak AI Overviews lub sekcja PAA spychają wyniki organiczne w dół, traktuję to jako wyparcie, a nie kanibalizację.
Test 3, gradient intencji. Porównuję tytuły, nagłówki H1 oraz pokrycie encji w pierwszym akapicie. Jeśli jedna strona ma charakter informacyjny, a druga transakcyjny, lub jedna jest dla początkujących, a druga dla zaawansowanych użytkowników, to nakładanie się może być zdrową segmentacją.
Test 4, rozkład CTR. Jeśli wyświetlenia rozkładają się między dwa adresy URL, ale kliknięcia są niższe niż powinna uzyskać jedna silniejsza strona, to jest to zmarnowana przestrzeń. Problem polega nie tylko na tym, że istnieją dwie strony, ale na tym, że żadna z nich nie przekształca dostępnej uwagi w sposób efektywny.
| Test | Co mierzy | Sygnał prawdziwej kanibalizacji | Sygnał szumu |
|---|---|---|---|
| Częstotliwość przełączania | Własność adresu URL w czasie | Dwa adresy URL powtarzalnie się przeplatają | Jeden adres URL pozostaje dominujący |
| Korelacja funkcji SERP | Wypieranie organiczne | Strata zbiega się z zatłoczeniem funkcji | Nakładanie się tylko odzwierciedla zmienność SERP |
| Gradient intencji | Różne potrzeby użytkowników | Ta sama intencja, ta sama grupa odbiorców, ta sama funkcja strony | Wyraźny podział informacyjny vs transakcyjny |
| Rozkład CTR | Efektywność kliknięć | Podzielone wyświetlenia ze słabymi łącznymi kliknięciami | Jeden adres URL dominuje w kliknięciach pomimo nakładania się |
Pomocny jest działający przykład. Dla „najlepszych butów do biegania”, Widziałem, że zarówno artykuł typu „listicle”, jak i recenzja mogą się pozycjonować, ale zapytanie zmienia się w zależności od budżetu i przypadku użycia. To zazwyczaj segmentacja, ponieważ każda strona obsługuje inny pod-cel. Zachowałbym obie i doprecyzował ich targetowanie.
Lepszym przykładem kanibalizacji jest „jak zresetować iPhone'a”. Kiedy wsparcie Apple i blog przeplatają się na pozycjach 4 i 6, a łączny CTR jest niższy niż ten, który powinien uzyskać pojedynczy stabilny wynik, witryna sygnalizuje zamieszanie. To nie jest problem ekosystemu treści, to problem własności zapytania.
Strona nie musi być identyczna z inną, aby ją kanibalizować. Wystarczy, że nadal będzie odbierać tę samą okazję do kliknięcia, nie zdobywając jej w czysty sposób.
Jak wygląda prawdziwy audyt
W średniej wielkości witrynie e-commerce z około 2400 adresów URL produktów i kategorii, zaczynam od pobrania danych z 16 miesięcy danych z Search Console, aby sezonowy popyt nie ukrywał wzorca. Ten szerszy widok jest ważny w przypadku witryn e-commerce, ponieważ zapytanie może wyglądać na stabilne podczas jednego cyklu zakupowego i niestabilne w innym. Filtruję do zapytań ze średnią 50+ wyświetleń miesięcznie i zachowuję tylko te z 2 lub więcej adresami URL w rankingu.
Następnie przestawiam dane według zapytań i obserwuję, które adresy URL pojawiają się w czasie. Dla zapytania takiego jak „bezprzewodowe słuchawki”, oznaczyłem każdą parę adresów URL według czasu nakładania się i znalazłem stronę kategorii oraz poradnik zakupowy, które obie utrzymywały pozycje w top 5 przez siedem miesięcy, zmieniając się z tygodnia na tydzień. To był prawdziwy przypadek kanibalizacji, ponieważ własność ciągle się zmieniała i żadna strona nie przyjęła jasnej roli.
Następnie nałożyłem dane z indeksowania Screaming Frog, aby sprawdzić wewnętrzne linki. Słabsza strona miała więcej kotwic kontekstowych niż powinna, co częściowo wyjaśniało zamieszanie. Silniejsza strona była rozwadniana przez wzorzec nawigacji, który wyglądał schludnie w CMS, ale niechlujnie w danych z indeksowania.
Ten sam zbiór danych dał mi fałszywy trop dotyczący „słuchawek bezprzewodowych do biegania”. Surowy eksport wyglądał niemal identycznie, ale strony zostały wyraźnie podzielone według intencji: jedna jako lista, druga jako strona produktu. Zrezygnowałem wtedy z planu przekierowania, ponieważ konsolidacja zaszkodziłaby pokryciu długiego ogona i usunęła użyteczną ścieżkę dla kupujących o bardziej specyficznych potrzebach.
Dla zespołów robiących to na dużą skalę, przeprowadzanie audytu SEO dla agencji framework jest solidnym towarzyszem, ponieważ wymusza przejście od odkrywania do priorytetyzacji, nie pomijając śladu dowodowego.
Logika przestawienia, której użyłem
- Trzymaj razem: to samo zapytanie, ta sama intencja, niestabilna własność.
- Rozdziel: ten sam ciąg zapytania, inna publiczność lub przypadek użycia.
- Opóźnij działanie: istnieje nakładanie się, ale jeden adres URL konsekwentnie przyciąga kliknięcia.
Ten ostatni koszyk jest tym, który wiele zespołów ignoruje. Strona, która wygląda niechlujnie w arkuszu kalkulacyjnym, może być nadal funkcjonalna, jeśli Search Console pokazuje jeden dominujący adres URL i brak znaczących zmian własności. Nauczyłem się nie „naprawiać” tych przypadków tylko dlatego, że eksport wygląda nieporządnie.
Ocenianie i priorytetyzacja zapytań wartych naprawy
Gdy lista kandydatów jest czysta, oceniam każde zapytanie, aby nie marnować czasu na nisko wartościowe nakładanie się. Mój model wykorzystuje pięć osi, każda oceniana od 0 do 3. Celem nie jest matematyczna doskonałość, ale oddzielenie zapytań, które uzasadniają działanie, od tych, które powinny pozostać pod obserwacją.
Model oceniania, którego używam
- Brama wolumenu. Wyższe miesięczne wyświetlenia otrzymują wyższą ocenę, ponieważ potencjalne korzyści są większe.
- Wartość przychodów lub konwersji. Komercyjny klaster zapytań jest ważniejszy niż próżny termin informacyjny.
- Zmienność pozycji. Więcej zamian rankingów miesięcznie oznacza większą niestabilność.
- Deficyt CTR. Szersza luka w porównaniu do przewidywanej krzywej kliknięć na najwyższej pozycji oznacza więcej zmarnowanego popytu.
- Łatwość naprawy. Strony z podobną treścią i jasnym podziałem linków są łatwiejsze do naprawienia.
Wszystko poniżej wrzucam 7/15 do kategorii „tylko monitoruj”. Z mojego doświadczenia wynika, że te zapytania zazwyczaj nie spełniają testu kosztów, pułap odzysku jest zbyt niski, lub intencja jest zbyt niejednoznaczna, aby można było je bezpiecznie oczyścić. Zapytania z wyższym wynikiem przechodzą do kategorii „napraw teraz” lub „zaplanuj na następny sprint”, w zależności od tego, jak bezpośrednio można rozwiązać problemy z adresami URL.
Jeśli grupowanie wykonujesz przed oceną, przepływ pracy grupowania słów kluczowych pomaga, ponieważ sprawia, że tematy na poziomie strony stają się bardziej oczywiste, zanim zaczniesz decydować, który adres URL powinien je obsługiwać.
| Kryterium | Waga (0-3) | Co oceniać | Próg działania |
|---|---|---|---|
| Średnia miesięczna liczba wyświetleń | 0-3 | Popyt i potencjał | Większy wolumen podnosi priorytet |
| Wartość przychodów lub konwersji | 0-3 | Wpływ na biznes | Wartość komercyjna skłania do „napraw teraz” |
| Zmienność pozycji | 0-3 | Częstotliwość zamian | Częste zamiany wymagają uwagi |
| Deficyt CTR | 0-3 | Strata w porównaniu do oczekiwanych kliknięć | Wyraźny deficyt zwiększa pilność |
| Łatwość naprawy | 0-3 | Podobieństwo i podział linków | Prostsze naprawy dają wyższy wynik |
Używając wcześniejszego przykładu, „bezprzewodowe słuchawki” zazwyczaj uzyskałyby wysoki wynik, ponieważ mają wartość komercyjną, widoczną zmienność i prawdopodobną ścieżkę konsolidacji. „bezprzewodowe słuchawki do biegania” uzyskałyby zazwyczaj niższy wynik, ponieważ podział intencji jest czystszy, a uzasadnienie biznesowe dla scalenia jest słabe. Wolałbym monitorować to drugie zapytanie, niż forsować scalenie, które zaciemnia odkrywanie produktów.
Zabezpieczenie: Nie zatwierdzam żadnego scalenia, chyba że strony mają wyraźne pokrycie intencji, które jest wystarczająco silne, aby uzasadnić utratę jednego adresu URL.
Ta jedna zasada uratowała więcej ruchu niż jakikolwiek arkusz kalkulacyjny z wynikami. Pokusa nadmiernego scalania jest realna, zwłaszcza gdy klient chce szybkiego zwycięstwa, ale złe scalenie może wymazać użyteczne pokrycie w długim ogonie.
Lista kontrolna audytu i co następuje po identyfikacji
Czysty przepływ pracy identyfikacji kończy się krótką listą kontrolną, a nie stosem eksportów. Weryfikuję zapytanie w Search Console, mapuję każdy adres URL otrzymujący wyświetlenia, sprawdzam tygodniowe zmiany, uruchamiam site: sprawdź, przeanalizuj pobranie danych, a następnie potwierdź historię pozycji. Jeśli zapytanie przejdzie co najmniej dwie z trzech warstw walidacji i uzyska wystarczająco wysoki wynik, aby miało to znaczenie, otrzymuje plan działania.
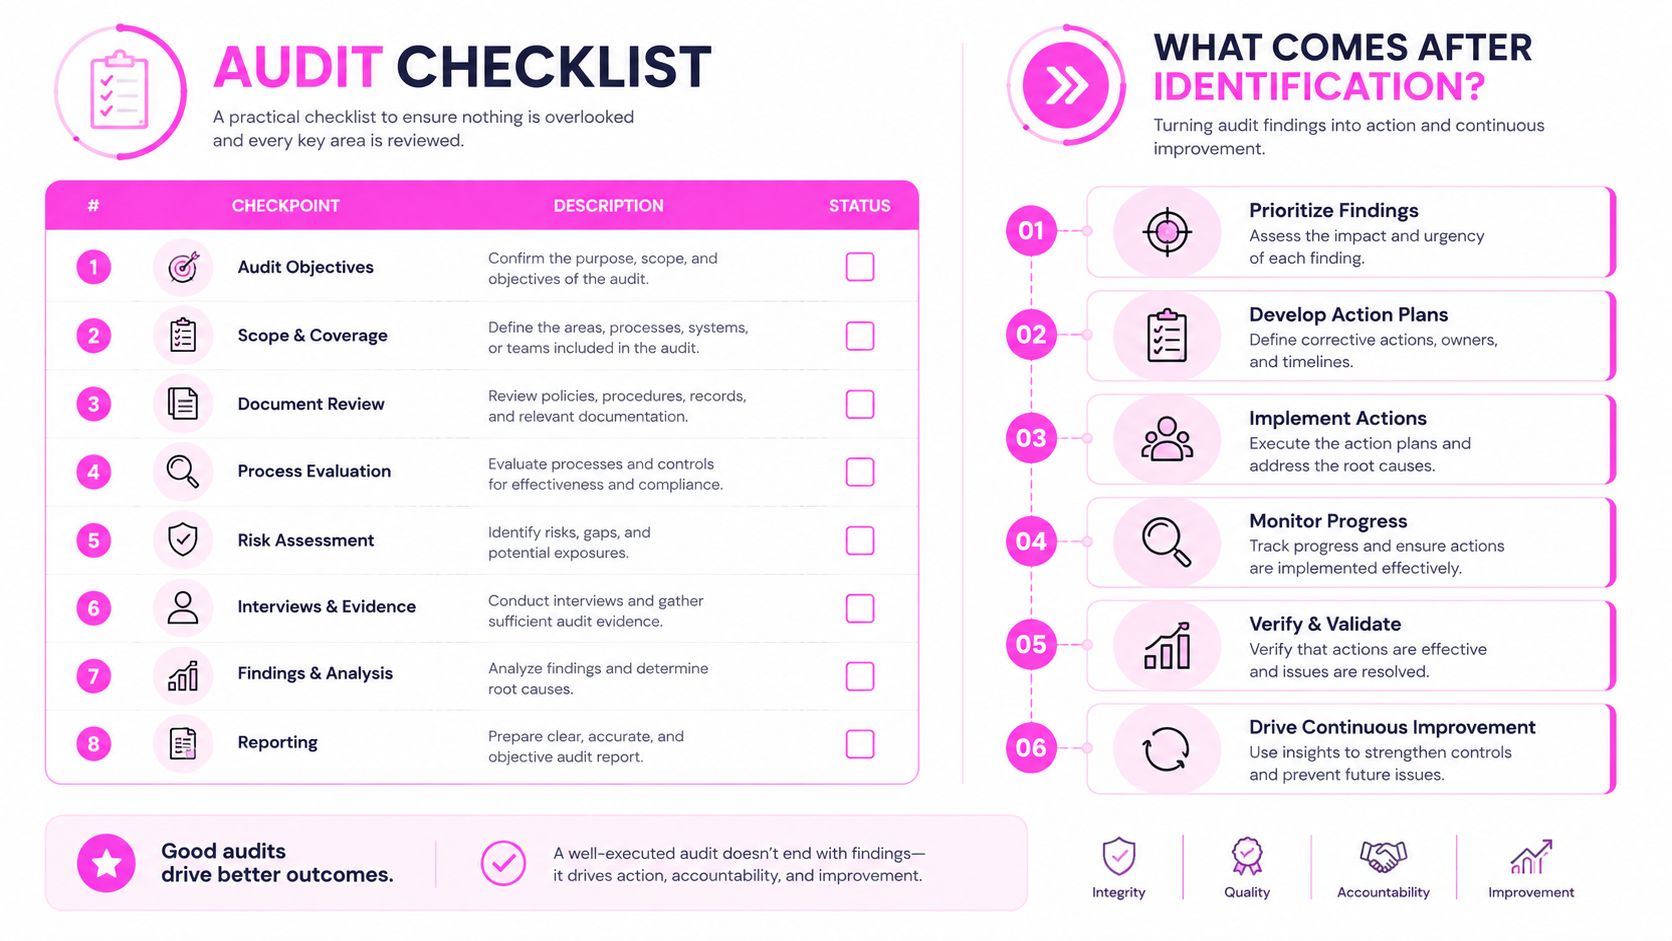
Ścieżka działania, którą stosuję po identyfikacji
- Ustaw tag canonical dla niemal duplikatów gdy strony są w zasadzie takie same i obie muszą istnieć.
- Przekierowanie 301 gdy jeden adres URL wyraźnie dominuje w danym temacie, a drugi tylko osłabia sygnał.
- Połącz treść tylko wtedy, gdy strony są strukturalnie zbędne, a jedna połączona strona może obsłużyć obie.
- Skonsoliduj linki wewnętrzne aby wyobrana strona otrzymała najsilniejsze wsparcie.
- Sprawdź ponownie za 30 dni w Search Console, aby potwierdzić, że własność zapytania się ustabilizowała.
- Przestań poprawiać gdy strona wykazuje stabilną własność, a nakładanie się jest celowe.
Największą pułapką jest traktowanie każdej oznaczonej pary jak kandydata do połączenia. W ten sposób zespoły niszczą przydatne warianty intencji i tracą ruch z długiego ogona, od którego – jak się okazuje – zależały. Lepsze rezultaty osiągam, naprawiając najpierw zapytania o niestałej własności, a celowe nakładanie się zostawiam w spokoju, jeśli sygnały pokazują, że to działa.
Jeśli po 30-dniowym przeglądzie schemat nadal jest chaotyczny, zanim dotknę samej treści, ponownie analizuję intencje oraz linkowanie wewnętrzne. Własność zapytań zazwyczaj podpowiada, czy strona wymaga przebudowy, czy po prostu wyraźniejszych sygnałów. Gdy to jest stabilne, problem przestaje być kanibalizacją, a staje się zwykłą konserwacją.
Jeśli chcesz szybciej wykrywać problemy z własnością zapytań na poziomie stron, słów kluczowych i wyników wyszukiwania, zobacz, jak SemDash (SemDash) mapuje pokrywające się adresy URL i klastry tematyczne w jednym miejscu. Używam takich narzędzi, gdy chcę przejść od diagnozy do ustalania priorytetów, nie tracąc wątku łączącego Search Console, historię rankingów i intencję konkretnej strony.