Zautomatyzowane odzyskiwanie linków: Jak wykrywać i naprawiać martwe linki
Automatyczne odzyskiwanie linków łączy trzy zautomatyzowane kroki: wykrywanie niedziałających linków poprzez zaplanowane skanowanie, generowanie poprawek, takich jak przekierowania lub zamienniki archiwalne, oraz monitorowanie wyników, aby Twoja witryna przestała tracić wartość SEO z powodu martwych linków. Większość zespołów powinna zautomatyzować wykrywanie i poprawki niskiego ryzyka, ale zachować ręczne przeglądy dla kluczowych stron i domen odsyłających o wysokiej wartości.
W skrócie:
- Narzędzia do automatycznego odzyskiwania linków zazwyczaj wykrywają i naprawiają niedziałające linki poprzez zaplanowane skanowanie, ale ręczny przegląd pozostaje niezbędny dla stron o wysokiej wartości lub kluczowych stron.
- Najlepsze metody wykrywania wykorzystują renderowanie bez nagłówka do identyfikacji linków wstrzykiwanych przez JavaScript oraz analizują status HTTP, łańcuchy przekierowań, miękkie błędy 404 i status indeksu Google, aby uzyskać dokładne wyniki.
- Poprawki opierają się na konfiguracji przekierowań, dopasowywaniu rozmytych ścieżek, migawkach z Wayback Machine i sugestiach AI, przy czym ręczny przegląd jest zalecany, zwłaszcza w przypadku zamienników generowanych przez AI.
- Budowanie bezpiecznego przepływu pracy obejmuje ustawienie odpowiednich częstotliwości skanowania, zastosowanie progów opóźnienia przed naprawą i testowanie przekierowań w środowiskach stagingowych, aby zapobiec spadkom rankingów.
- Większość zespołów powinna traktować automatyzację jako system priorytetyzacji i triage, ustawiając wysokie progi pewności i ponownie przeglądając wymiany archiwów, aby zapewnić ciągłość integralności linków i wartości SEO.
Czym jest zautomatyzowane odzyskiwanie linków i które narzędzia pasują do Twojej witryny?
Narzędzia w tej przestrzeni dzielą się na cztery rodziny, a wybór niewłaściwego marnuje więcej czasu niż nierobienie niczego. Każde z nich inaczej równoważy szybkość z kontrolą redakcyjną, a właściwy wybór zależy od wielkości Twojej witryny i tego, ile ryzyka możesz tolerować na stronach o dużym natężeniu ruchu.
- Monitory SaaS (takie jak platformy monitorowania linków zwrotnych) przeprowadzają ciągłe kontrole stron dawców i powiadamiają Cię, gdy link zniknie lub otrzyma
nofollowtag, idealne dla agencji śledzących portfolio klientów. - Wtyczki CMS takie jak Archivarix Broken Links Recovery skanuje strony WordPress bezpośrednio, oferując automatyczne zamienniki Wayback obok trybu ręcznego i poleceń WP-CLI do operacji masowych.
- Narzędzia CLI i autofix takie jak site-autofix, które przeszukują z użyciem przeglądarki bez interfejsu graficznego i generują gotowe do wdrożenia konfiguracje przekierowań, najlepsze dla programistów przyzwyczajonych do pracy w terminalu.
- Zamienniki archiwów automatycznie zamienia martwe linki na migawki z Wayback Machine, przydatne dla stron z dużą ilością treści, gdzie znalezienie zamiennika na żywo nie jest realistyczne.
Zarządzany SaaS wygrywa, gdy potrzebujesz alertów dla dziesiątek domen bez dotykania kodu. Wtyczka lub CLI wygrywa, gdy chcesz zastosować poprawkę w swoim własnym potoku wdrażania.
Jak zautomatyzowane wykrywanie znajduje niedziałające linki?
Wykrywanie zaczyna się od indeksowania, ale nie wszystkie indeksowania widzą tę samą sieć. Statyczne indeksery pobierają surowy kod HTML i pomijają linki wstrzykiwane przez JavaScript, dlatego nowoczesne narzędzia zamiast tego używają renderowania bez interfejsu graficznego. Site-autofix, na przykład, indeksuje za pomocą Playwright więc widzi DOM tak, jak przeglądarka faktycznie go renderuje, wyłapując linki, których proste pobranie HTTP nigdy by nie znalazło.
Poza renderowaniem, solidne warstwy detekcji w kilku kontrolach:
- Weryfikacja statusu HTTP oznacza jawne odpowiedzi 4xx i 5xx.
- Analiza łańcucha przekierowań wyłapuje linki, które technicznie się rozwiązują, ale przeskakują przez trzy lub cztery przeskoki, cicho rozcieńczając w tym czasie wartość.
- Wykrywanie błędów Soft 404 identyfikuje strony, które zwracają status
200, ale wyświetlają treść „nie znaleziono strony”, co jest trybem awarii, który zwykłe sprawdzenia statusu całkowicie pomijają. - Porównanie indeksu z Search Console pokazuje, czy Google już usunął docelową stronę, co pomaga w ustaleniu priorytetów: link do strony, którą Google nadal indeksuje, warto naprawić przed linkiem do strony, która zniknęła z indeksu dawno temu.
Pilność jest tu realna. Znaczna część zbudowanych linków znika w ciągu roku, a im szybciej wyłapiesz spadek, tym większe masz szanse na odzyskanie strony odsyłającej zamiast utraty jej na zawsze.
Jakie metody automatycznej naprawy faktycznie naprawiają zepsute linki?
Gdy narzędzie wykryje martwy link, silnik naprawczy decyduje, co go zastąpi. Dominują cztery podejścia, każde z innym profilem ryzyka.
- Generowanie przekierowań. Narzędzie mapuje starą ścieżkę na aktywny odpowiednik i generuje konfigurację gotową do wdrożenia. Site-autofix tworzy reguły przekierowań sformatowane dla Next.js, Netlify i nginx, dzięki czemu inżynierowie mogą wkleić wynik bezpośrednio do potoku wdrażania, zamiast ręcznie pisać reguły nadpisywania.
- Dopasowywanie ścieżek rozmytych. System ocenia kandydatów na adresy URL zastępcze, używając ważonego pokrycia segmentów ścieżki w połączeniu z odległością edycyjną Levenshteina, a następnie automatycznie stosuje poprawkę tylko powyżej określonego progu pewności, często powyżej 90% dla stron kanonicznych lub o dużym natężeniu ruchu.
- Zastępowanie przez Wayback. Narzędzia takie jak Fixie zastępują martwy link migawką z Wayback Machine i otwierają pull request zamiast publikować bezpośrednio, dając człowiekowi ostatnie słowo przed opublikowaniem zmiany.
- Zastępowanie sugerowane przez AI. Model proponuje kontekstowo odpowiednią stronę docelową, gdy nie ma dokładnego dopasowania, co jest przydatne w przypadku treści osieroconych, ale bardziej ryzykowne, ponieważ może błędnie ocenić intencje w subtelnych tematach.
Wskazówka Pro: Nigdy nie pozwól, aby automatycznie publikowana była sugerowana przez AI zamiana na stronie, która generuje przychody lub zajmuje wysokie pozycje w konkurencyjnym terminie. Przekieruj je do wersji roboczej lub żądania ściągnięcia, według tego samego schematu, którego używa Fixie, aby rzeczywisty redaktor potwierdził dopasowanie przed publikacją.
Prace akademickie nad tym problemem potwierdzają, że podstawowa koncepcja działa. Systemy wyszukiwania informacji zaprojektowane do rekomendowania zastępczych linków wykorzystujące sygnały kontekstowe mogą automatycznie wyszukiwać rozsądnych kandydatów, ale każda implementacja nadal potrzebuje bramki pewności przed podjęciem działania bez nadzoru.
Jak zbudować bezpieczny przepływ pracy odzyskiwania linków?
Przepływ pracy, który stale skanuje, ale niczego nie przegląda, jest równie niebezpieczny, jak ten, który wszystko przegląda i nigdy nie skanuje. Zbuduj go warstwowo.
- Ustaw częstotliwość skanowania w zależności od wielkości portfela. Małe strony (poniżej 500 stron) mogą przeprowadzać cotygodniowe skanowanie. Większe zasoby korzystają z codziennych skanów przyrostowych skupiających się na stronach, które ostatnio się zmieniły lub straciły ruch.
- Zastosuj progi opóźnień przed podjęciem działań. Link, który dzisiaj zwraca 404, może być tymczasowym problemem z serwerem. Poczekaj pełny dzień lub tydzień dla stron o niższym priorytecie, zanim uruchomisz poprawkę pozwala uniknąć reagowania na awarie, które same się rozwiązują.
- Kieruj alerty do odpowiedniego kanału. Połącz wyniki skanowania z Slackiem, e-mailem lub swoim narzędziem do śledzenia błędów, aby awarie trafiały tam, gdzie Twój zespół już pracuje, a nie na pulpit nawigacyjny, którego nikt nie sprawdza.
- Przetestuj konfiguracje przekierowań przed scaleniem. Uruchom wygenerowane reguły Next.js, Netlify lub nginx najpierw przez wdrożenie stagingowe i zachowaj poprzednią konfigurację dostępną do natychmiastowego wycofania.
Integracje są równie ważne jak samo skanowanie:
- Informacje z Search Console mówią Ci, czy docelowa strona jest nadal zaindeksowana, zanim skierujesz do niej ruch.
- Potoki CI pozwalają na przejście konfiguracji przekierowań przez ten sam proces przeglądu, co kod.
- Systemy śledzenia zgłoszeń zapewniają dokumentację naprawy niedziałających linków obok wszystkich innych zadań inżynieryjnych.
Gdzie automatyzacja linków idzie źle?
Automatyzacja zawodzi po cichu, a szkody zazwyczaj ujawniają się tygodnie później jako spadek pozycji, którego nikt nie potrafi wyjaśnić. Kilka wzorców powoduje większość problemów.
- Automatyczne zastępowanie linku w kluczowych treściach migawką z Wayback Machine może spowodować podmianę nieaktualnych cen, wycofanych produktów lub stanowiska, którego firma już nie zajmuje. Dokumentacja Archivarix zaleca tryb ręczny specjalnie dla tych stron.
- Natychmiastowe naprawianie zewnętrznego błędu 404 ryzykuje działanie na serwerze, który jest po prostu niedostępny z powodu konserwacji. Opóźnienie ustawienia na dzień lub dłużej filtruje większość fałszywych pozytywów.
- Pomijanie logów oznacza, że nie możesz wyjaśnić klientowi ani sobie w przyszłości, dlaczego adres URL zmienił się sześć miesięcy temu.
- Traktowanie zakupionego lub zdobytego linku zwrotnego tak samo jak wewnętrznego zepsutego linku jest błędem. Przekierowanie nie odzyska linku, który strona partnerska usunęła celowo; tylko kontakt z szablonem odzyskiwania przywróci tę relację i ten link.
Wskazówka Pro: Zachowaj tabelę audytu automatyzacji z oryginalnym adresem URL, typem błędu, sugerowaną poprawką, wskaźnikiem pewności, recenzentem i poleceniem wycofania. Zamienia to pięciominutową sesję rozwiązywania problemów w trzydziestosekundowe wyszukiwanie.
Jak Semdash wspiera zautomatyzowane odzyskiwanie linków
Ta praca nad priorytetyzacją łączy się bezpośrednio z kilkoma innymi elementami:
- Odzyskiwanie linków wskazówki dotyczące decydowania, które utracone linki zasługują na e-mail kontaktowy, a które na ciche przekierowanie.
- Indeksowanie linków zwrotnych sprawdza, czy docelowa strona nadal znajduje się w indeksie Google, zanim skierujesz w nią wartość linków.
- Metody audytu tekstu zakotwiczenia do wyłapywania linków wartych ochrony, zanim w ogóle się zepsują.
Razem zamieniają one odzyskiwanie z reaktywnej walki w uszeregowany, ciągły proces.
Co większość zespołów robi źle w kwestii automatyzacji linków
Większość porad na ten temat traktuje automatyzację jako przełącznik „wszystko albo nic”: albo pozwalasz narzędziu działać na całej stronie, albo ręcznie przeglądasz każdy uszkodzony link. Żadna z tych skrajności nie jest dobra. Witryny, które faktycznie zachowują swoją wartość linków, traktują automatyzację jako system priorytetyzacji, a nie maszynę do naprawiania wszystkiego.
Próg pewności jest ważniejszy niż wybrane narzędzie. Silnik dopasowania przybliżonego ustawiony na automatyczne stosowanie wszystkiego powyżej 60% z łatwością przekieruje stronę produktu do niewłaściwej kategorii. Ustaw ten próg powyżej 90% i zostaw wszystko poniżej dla człowieka, a to samo narzędzie stanie się godne zaufania. Ta pojedyncza liczba zrobi więcej dla Twoich rankingów niż zmiana dostawcy.
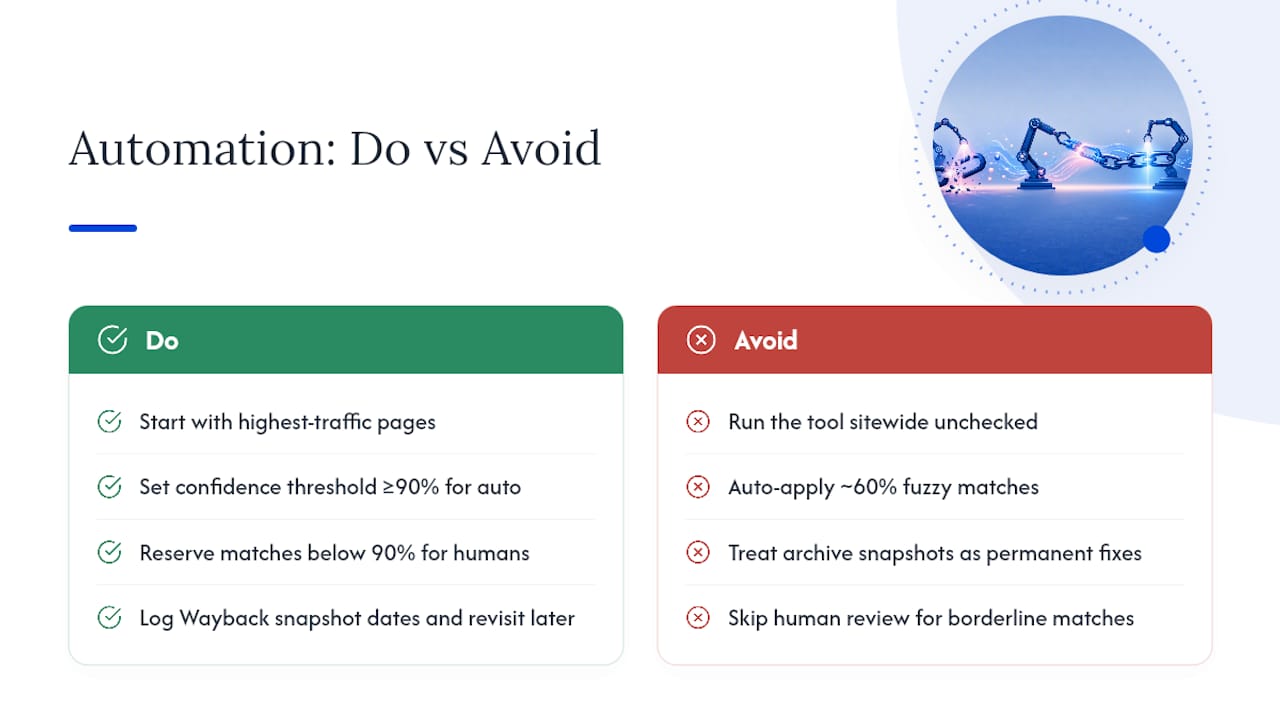
Innym pomijanym aspektem jest traktowanie zamienników archiwów jako stałego rozwiązania, a nie tymczasowego. Zrzut z Wayback Machine sprzed trzech lat kupuje czas; nie zastępuje on jednak pracy nad znalezieniem autentycznego, aktualnego źródła. Zespoły, które rejestrują datę zrzutu i wracają do niego później, osiągają lepsze wyniki niż zespoły, które uznają zadanie za zakończone po uruchomieniu przekierowania.
Zacznij od stron o najwyższym ruchu, ustaw progi opóźnień zachowawczo i pozwól automatyzacji zdobyć zaufanie najpierw na treściach o niskiej stawce.
— Leonid
Zautomatyzuj odzyskiwanie linków zwrotnych z Semdash
Manualne śledzenie zepsutych linków w rosnącym profilu linków zwrotnych pochłania godziny, których nie masz, zwłaszcza gdy próbujesz również ustalić, które linki warto w ogóle zachować. Semdash rozwiązuje problem priorytetyzacji, zanim dotkniesz jakiegokolwiek przekierowania: jego badań linków zwrotnych pokazuje dokładnie, które domeny odsyłające mają rzeczywisty autorytet, dzięki czemu wysiłek związany z odzyskiwaniem skupia się na linkach, które wpływają na rankingi, a nie na tych, które tego nie robią.
Połącz to z analiza luki linków zwrotnych konkurencji aby dostrzec możliwości odzyskania, które inaczej całkowicie byś przeoczył, strony linkujące do konkurentów, które równie dobrze mogłyby linkować do Ciebie. Zaimportuj swoją listę linków zwrotnych do Semdash i przeprowadź pierwsze skanowanie, aby zobaczyć, gdzie stoisz dzisiaj. Stamtąd decyzje dotyczące naprawy stają się znacznie łatwiejsze do podjęcia.
Źródła
- Automatyczne odzyskiwanie uszkodzonych linków przy użyciu informacji… (ACM)
- eliBenven/site-autofix
- Fixie (GitHub)
- Wordpress
FAQ
Jak mogę przywrócić stary link?
Sprawdź, czy oryginalna strona nadal istnieje pod nowym adresem URL, a jeśli nie, wyszukaj ją w Wayback Machine i albo linkuj do zarchiwizowanego migawki, albo odtwórz treść i przekieruj do niej. Narzędzia takie jak site-autofix automatyzują to, generując konfigurację przekierowania po znalezieniu odpowiedniego dopasowania.
Czym jest RecoveryLink?
„RecoveryLink” to nie jest standardowa, powszechnie znana nazwa produktu w tej branży; częściej jest używana ogólnie do określenia szerszej kategorii automatycznych narzędzi do odzyskiwania linków i monitorowania profilu linków zwrotnych. Narzędzie do badania linków zwrotnych Semdash obejmuje podstawowe prace wykrywcze i monitorujące, do których odnosi się ta nazwa kategorii.
Jak odzyskać link, który już nie działa?
Przeprowadź skanowanie, aby potwierdzić rodzaj błędu (404, pętla przekierowań lub miękkie 404), a następnie sprawdź Wayback Machine lub historię wersji w swoim systemie CMS, aby poznać pierwotny adres docelowy, zanim zdecydujesz się na przekierowanie, aktualizację treści lub kontakt z witryną linkującą.
Jak odzyskać wygasły link?
W przypadku linków wewnętrznych narzędzie dopasowania rozmytego zwykle potrafi znaleźć najbliższą działającą stronę i automatycznie utworzyć przekierowanie. W przypadku linków zewnętrznych wygaśnięcie zazwyczaj oznacza, że domena lub strona zniknęła na dobre – w takiej sytuacji bardziej niezawodnym rozwiązaniem jest kopia z Wayback Machine lub ręczny e-mail do właściciela witryny.
Jak często powinienem skanować w poszukiwaniu niedziałających linków?
Mniejsze strony poniżej 500 stron dobrze sobie radzą przy cotygodniowym skanowaniu, podczas gdy większe lub szybko zmieniające się portfolio korzystają z codziennych skanów przyrostowych skupionych na niedawno zaktualizowanych stronach.